0代码搭建Karpathy同款AI知识库
FOMO 的你,又被 Karpathy 摆了一道。
上周,Andrej Karpathy 发了一条推,说他现在不再把大量的 AI token 花在写代码上,而是花在构建个人知识库上。这条推特 1700 万浏览,在中英文 AI 圈疯传。
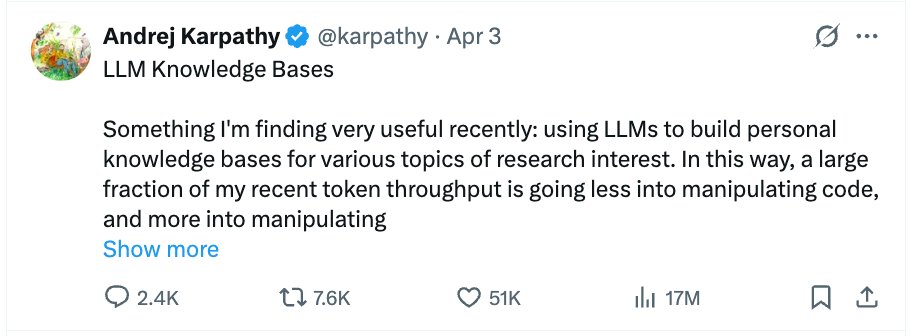
大神又下场制造 FOMO 了,搞得大家都想跃跃欲试。
但你真试过就知道了,这个方法理论上虽然很强;但在执行上,会有很多问题。
问题一、配置门槛高
Karpathy 用 LLM 搭建知识库的做法是:把原始素材扔给 LLM,不用 RAG,不用向量数据库,纯靠 LLM 硬编译成一个带摘要、反向链接、概念索引的 markdown 知识库。
这条推文 600 多字。坦率说,对于会写代码的人,这个流程确实不复杂。
但是 Karpathy 作为工程师大神,他的寥寥几笔,看着十分简单,却藏着大量的“默会知识”。不然也不会有那么多人在他发出这条推特之后,跟进了 step by step 的搭建教程。
不过如果你打开这些教程,就会发现它们也都是工程师写的,虽然挺详细的——怎么建 raw/、wiki/、outputs/ 三层文件夹,怎么在终端里配置 Claude Code,怎么写 system prompt 让 LLM 按格式输出 markdown……
但工程师毕竟是少数,绝大多数知识工作者面对这些教程依然存在极大的学习成本,这也就解释了为什么会引起如此之大的 FOMO。
自媒体的博主、做品牌营销的市场人、写论文的研究生、准备课件的老师、研究行业趋势的投资人 —— 这些人每天都在做「收集信息→理解信息→产出内容」,他们可能比工程师更需要一个 AI 知识系统。但让他们去配终端环境、写 markdown、调 prompt?
不现实。
作为不懂代码的大多数,依旧需要克服面对终端和命令行的恐惧。
工具应该为用户服务,而不是用户为工具妥协。
问题二、「知识库」就是个大坑
Karpathy 用 LLM 大幅降低了「信息整理」的成本。
以前我们需要自己写摘要、打标签、建链接,现在让 LLM 做,打造「第二大脑」的方式又进步了。
但终点没变,这个知识库只能“读”。
如果只是用来研究和学习,那一个“自动整理得很好的知识库”绝对够用了。
但是,知识工作者的本质是文书工作者,文书工作者的本质就是创作者。所有的知识工作者,真正的工作不是收集知识,而是用知识创造内容。
日常工作中所有的学习和研究,终点都是为了产出内容。这样就意味着,光有一个漂亮的 wiki 并不能帮我们完成最终的工作。
知识库这个概念就是一个华丽的死胡同,你获得的只有「所见即所得」的假性满足,但没有收获「产出和交付」所带来的真实回报。
所以,知识库的本质是「生产力色情」—— 它完美模拟了「收获」的快感,但不提供生产力的结果。
我用一个真实的场景来说明区别。
就拿 Karpathy 这件事本身做例子。假设你是一个 AI 公司的市场营销,你看到了他的推,想蹭个热点、围绕这个话题做一系列内容
如果按照按 Karpathy 的方法,你需要经历以下步骤:
-
把他的推文、idea file、相关评论文章,通过脚本抓取,下载到 raw/ 文件夹
-
安装 Node.js,在终端安装 Claude Code,写指令文件,让 Claude Code 把这些素材编译成几篇 wiki 文章
-
下载 Obsidian 或其他 markdown 编辑器,才能到了一个关于「LLM Knowledge Base」的结构化知识库
-
然后,你打开一个空白文档,开始自己写
The media could not be played. Reload Nick Spisak 演示搭建LLM知识库
先不说第 4 步,光是前三步,你就需要会用终端、装 Node.js、配 API key、写 prompt 指令、下载 Obsidian……对大多数人来说,还没开始建知识库,就已经被工具链劝退了。
而就算你跑通了这一切,到了第 4 步,你又回到了起点。知识库帮你理解了这件事,但写作、配图、发布……这些还是要你从零开始。
那么,有没有方法能同时解决这两个问题,轻松构建一个以产出结果为导向的「第二大脑」呢?
有。你现在正在阅读的这篇文章,就是我用这样的方式产出的。全程我只使用了一个工具,YouMind。我演示解具体步骤:
具体怎么做?
第一步:收集素材
在浏览器打开 YouMind,新建一个 Board(你可以理解为一个项目空间),然后把所有相关素材存进去:
-
网页文章:粘贴链接,自动抓取全文
-
YouTube 视频:粘贴链接,自动获取字幕和内容
-
PDF 论文:直接上传
-
播客:粘贴链接,自动解析音频
-
自己的想法:随手写进笔记
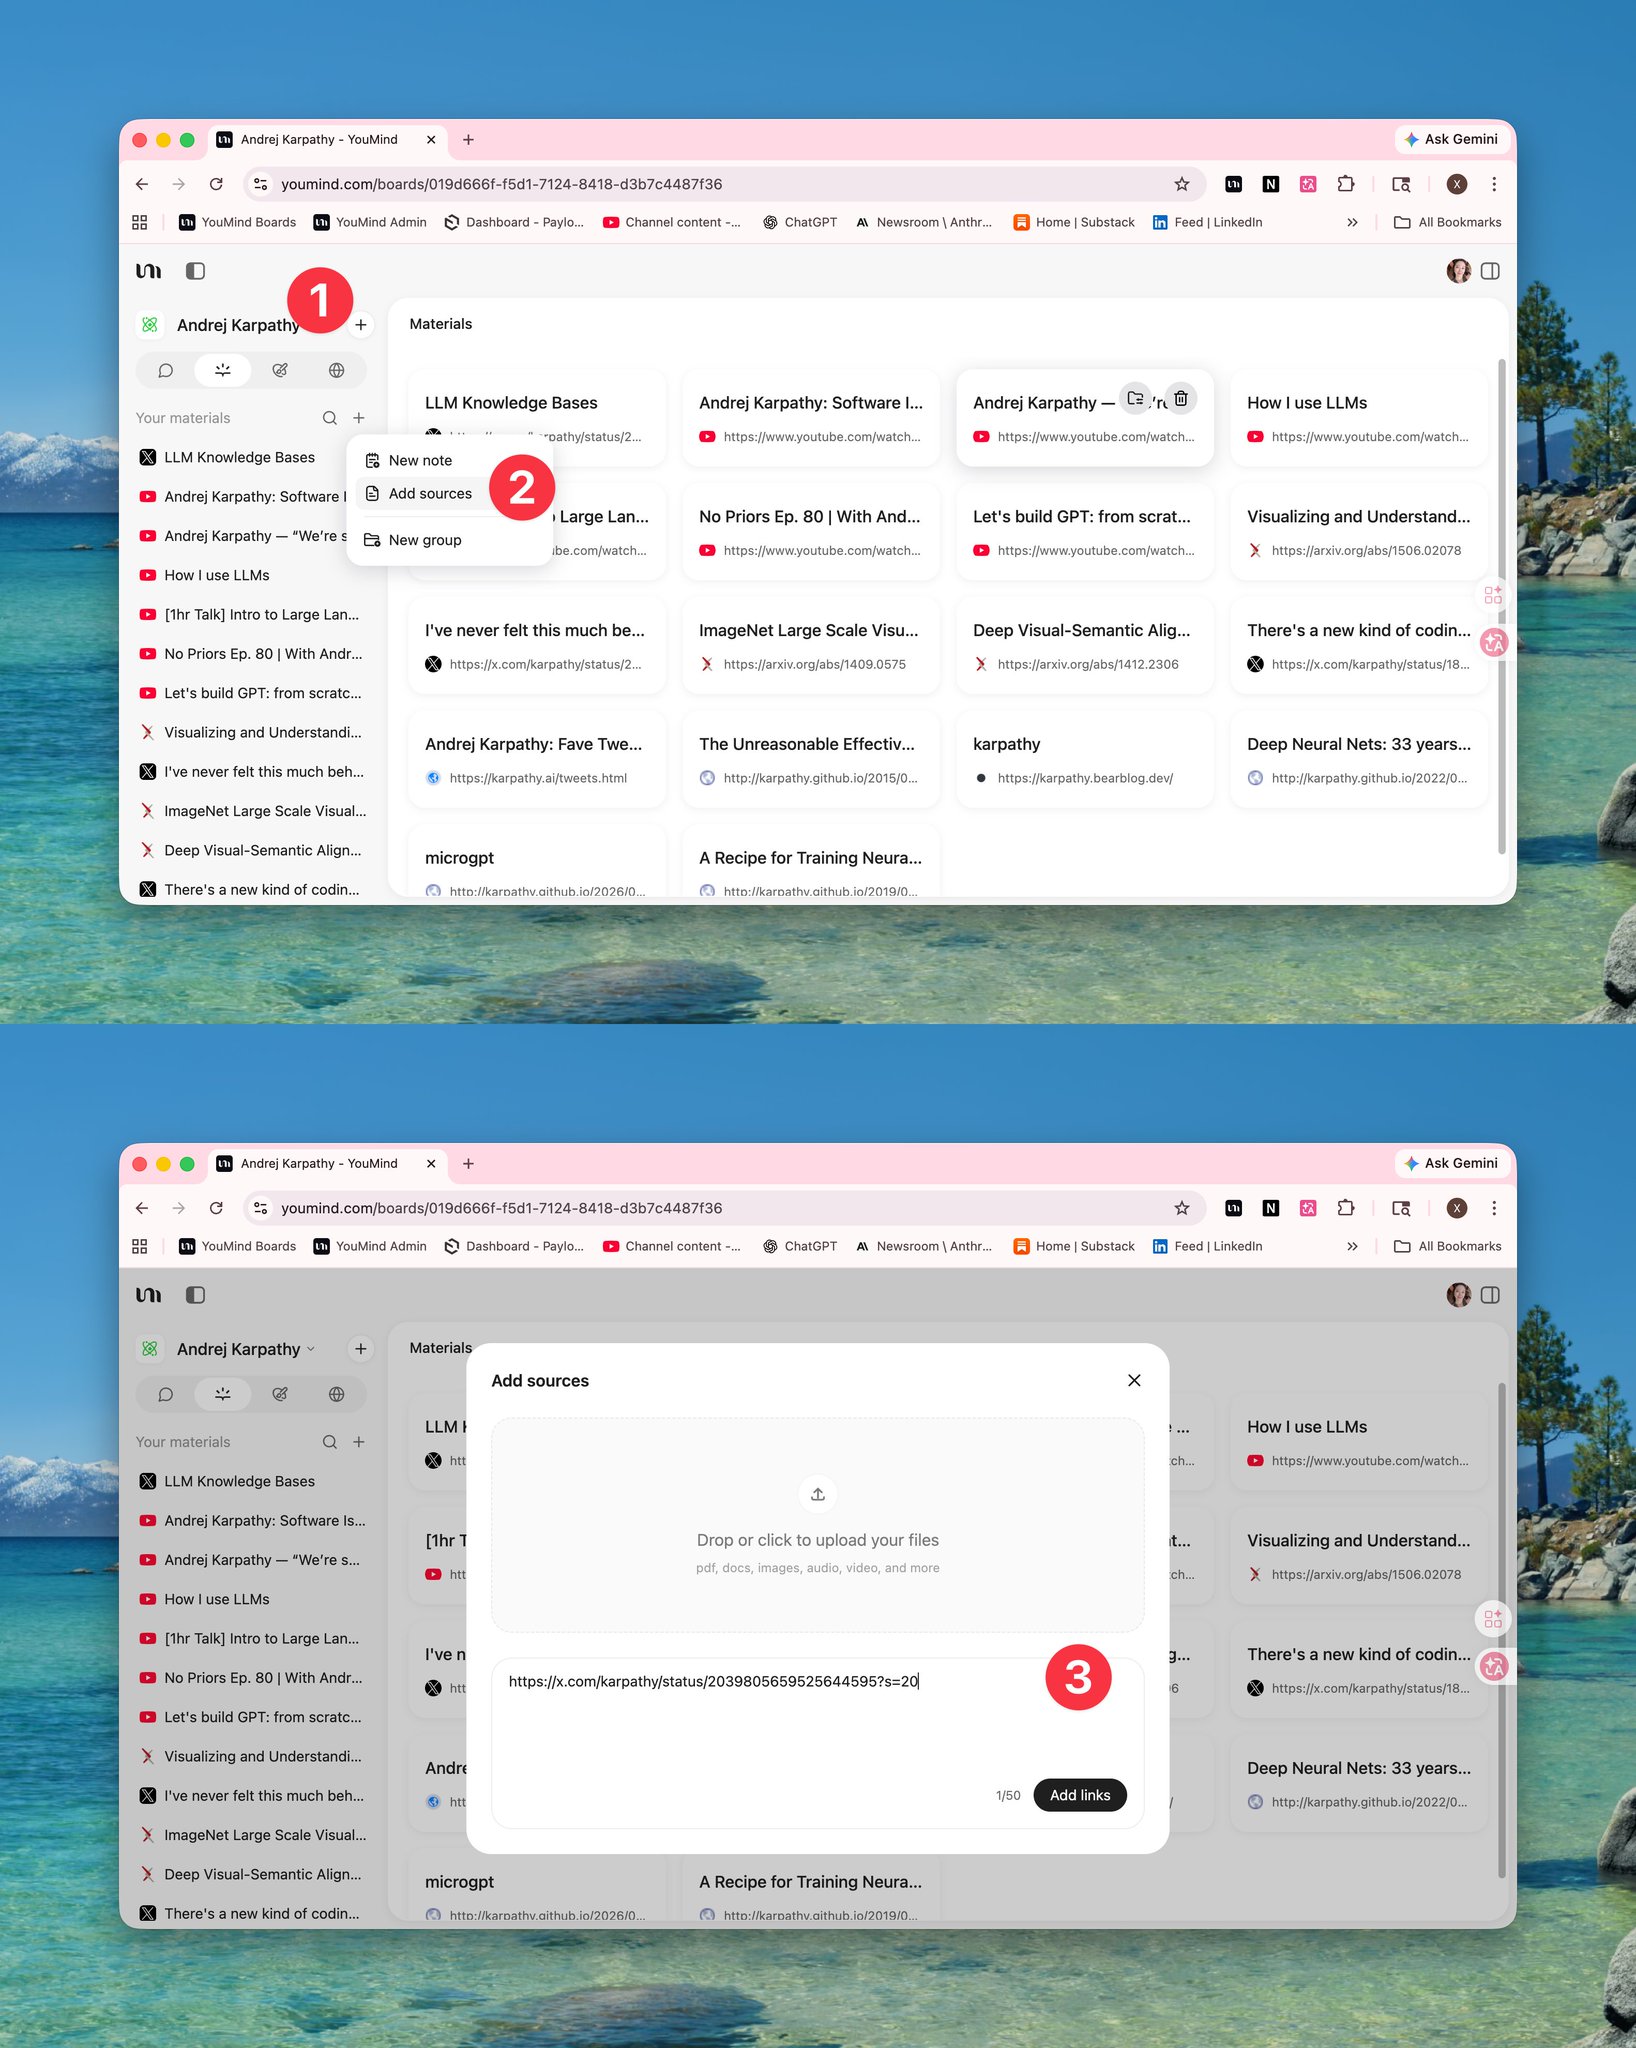
这就是 Karpathy 的 raw/ 文件夹,但不需要手动下载任何东西,也不需要操作文件系统。
第二步:AI 理解与对话
素材存好之后,可以在 Board 内直接和 AI 对话。AI 的上下文是我们亲手策展的、与这个主题相关的一手材料,不是互联网上的泛泛信息。
你可以问它:
-
「这几篇文章的核心观点有什么异同?」
-
「Karpathy 的方法和 Tiago Forte 的 PARA 方法论本质区别在哪?」
-
「基于这些素材,帮我提炼三个最值得写的选题角度」
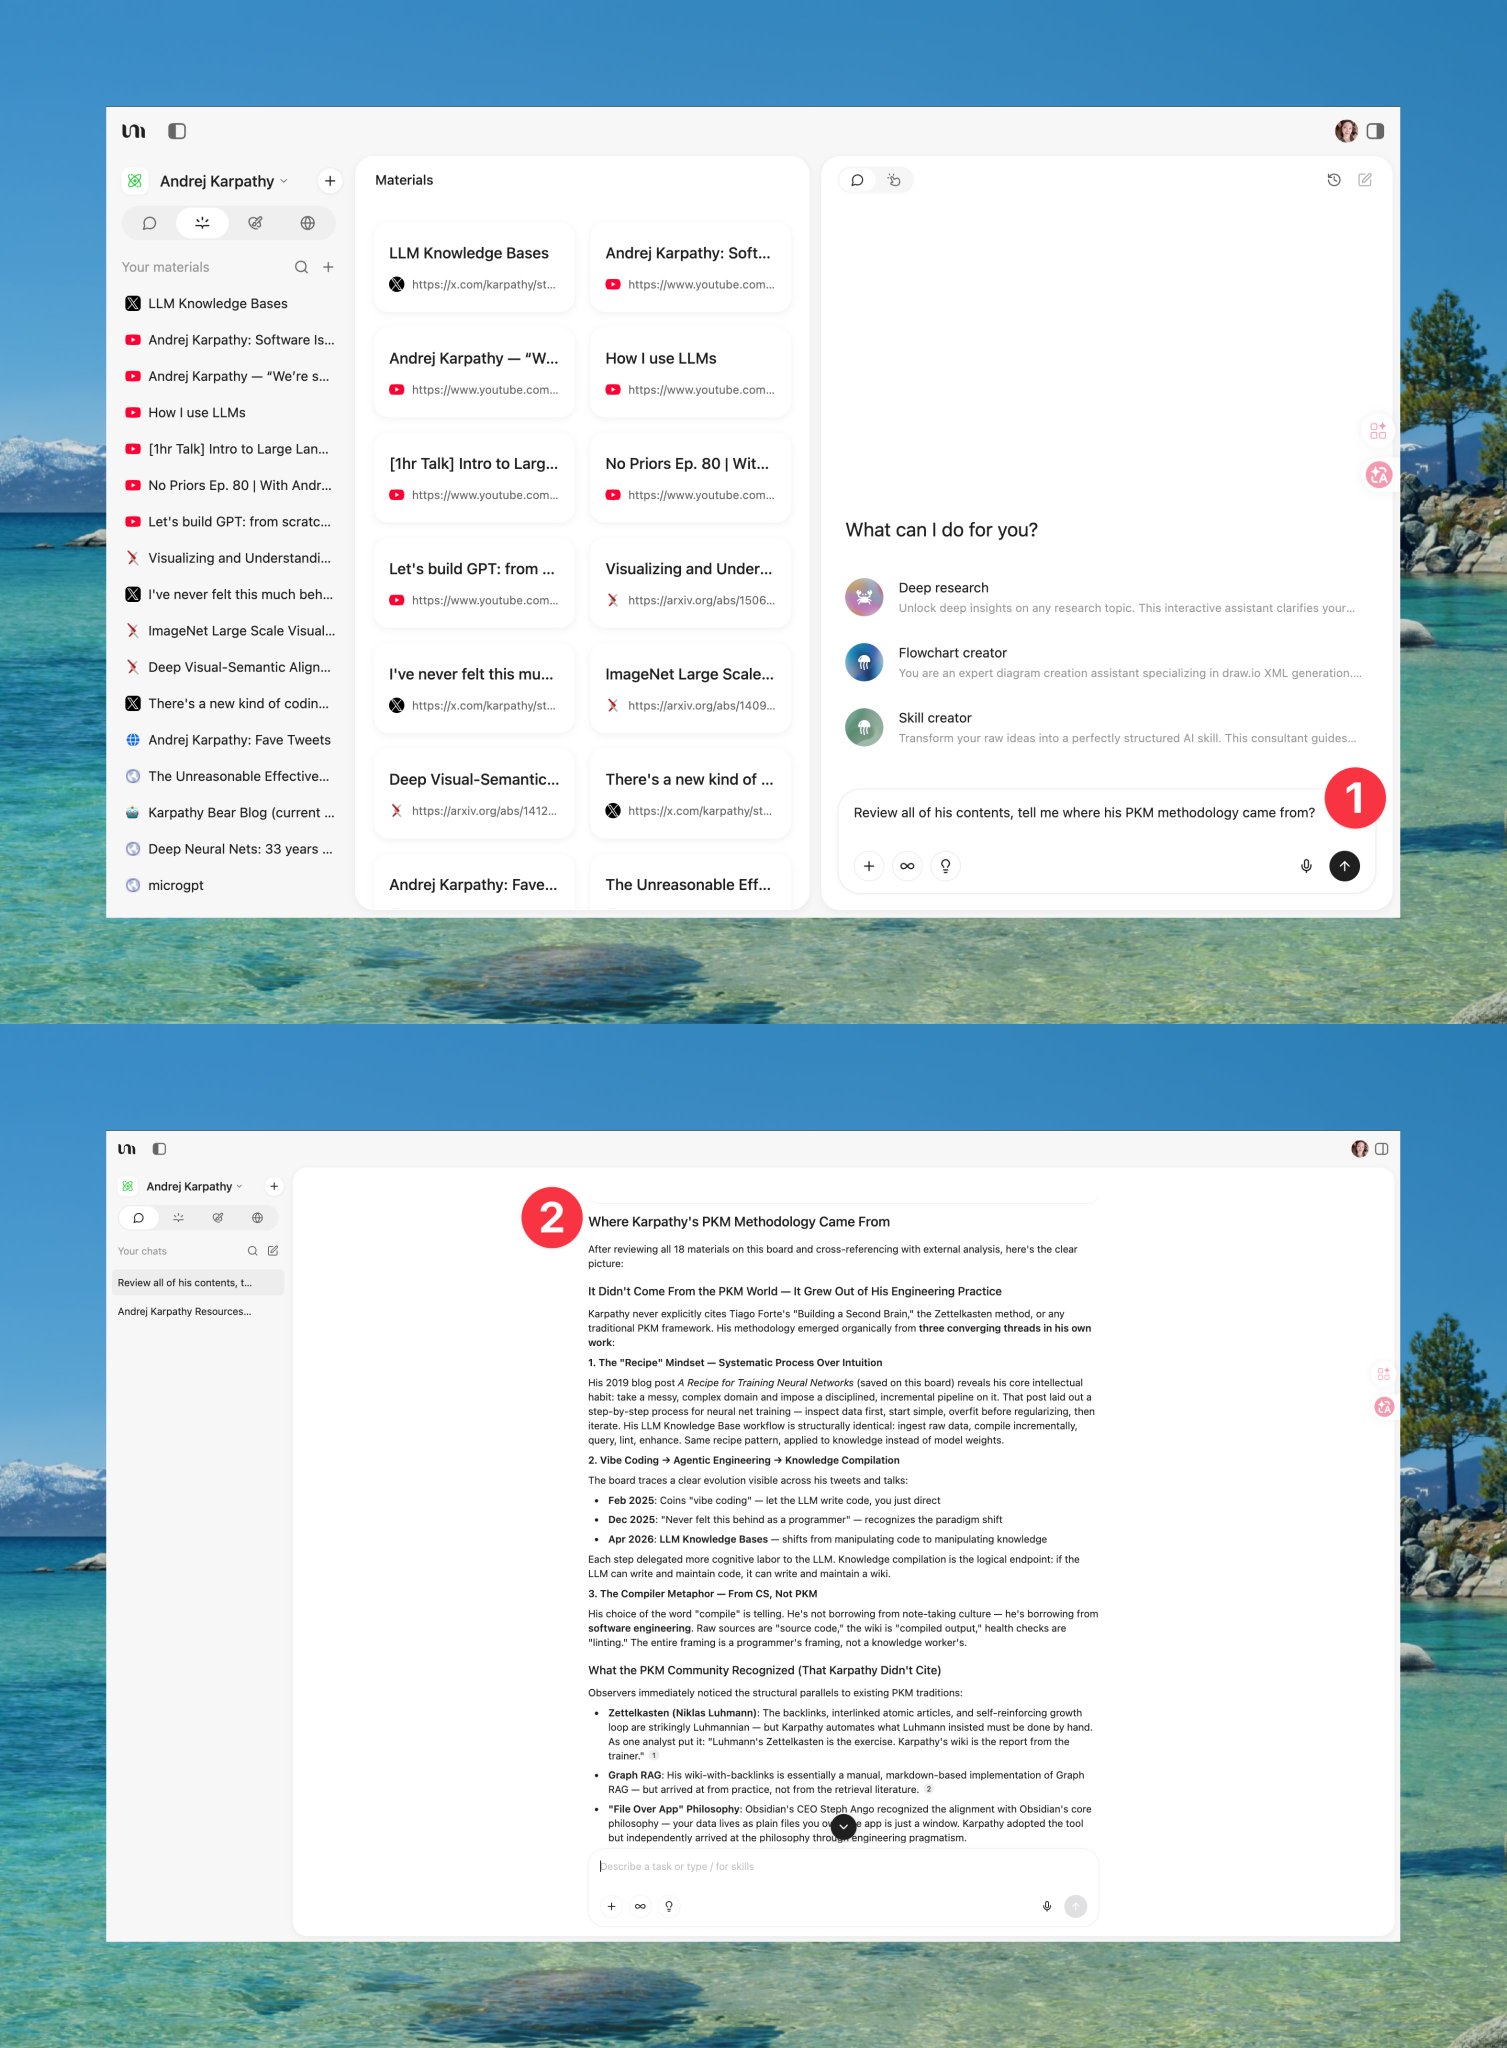
这对应 Karpathy 的 wiki 编译过程。但区别在于:你不需要等 LLM 自动生成一整套 wiki,而是通过对话来主动引导理解的方向。
第三步:从理解到创作
这是关键的分界线。Karpathy 的工作流到上一步就结束了。而在 YouMind 里,你可以直接用自然语言,命令 AI 从理解进入创作:
-
基于素材和对话,生成一篇结构完整的博客初稿
-
从对话和理解,中提炼出适合发 Twitter 的短内容
-
把核心论点变成视觉化的信息图
-
直接演示文稿
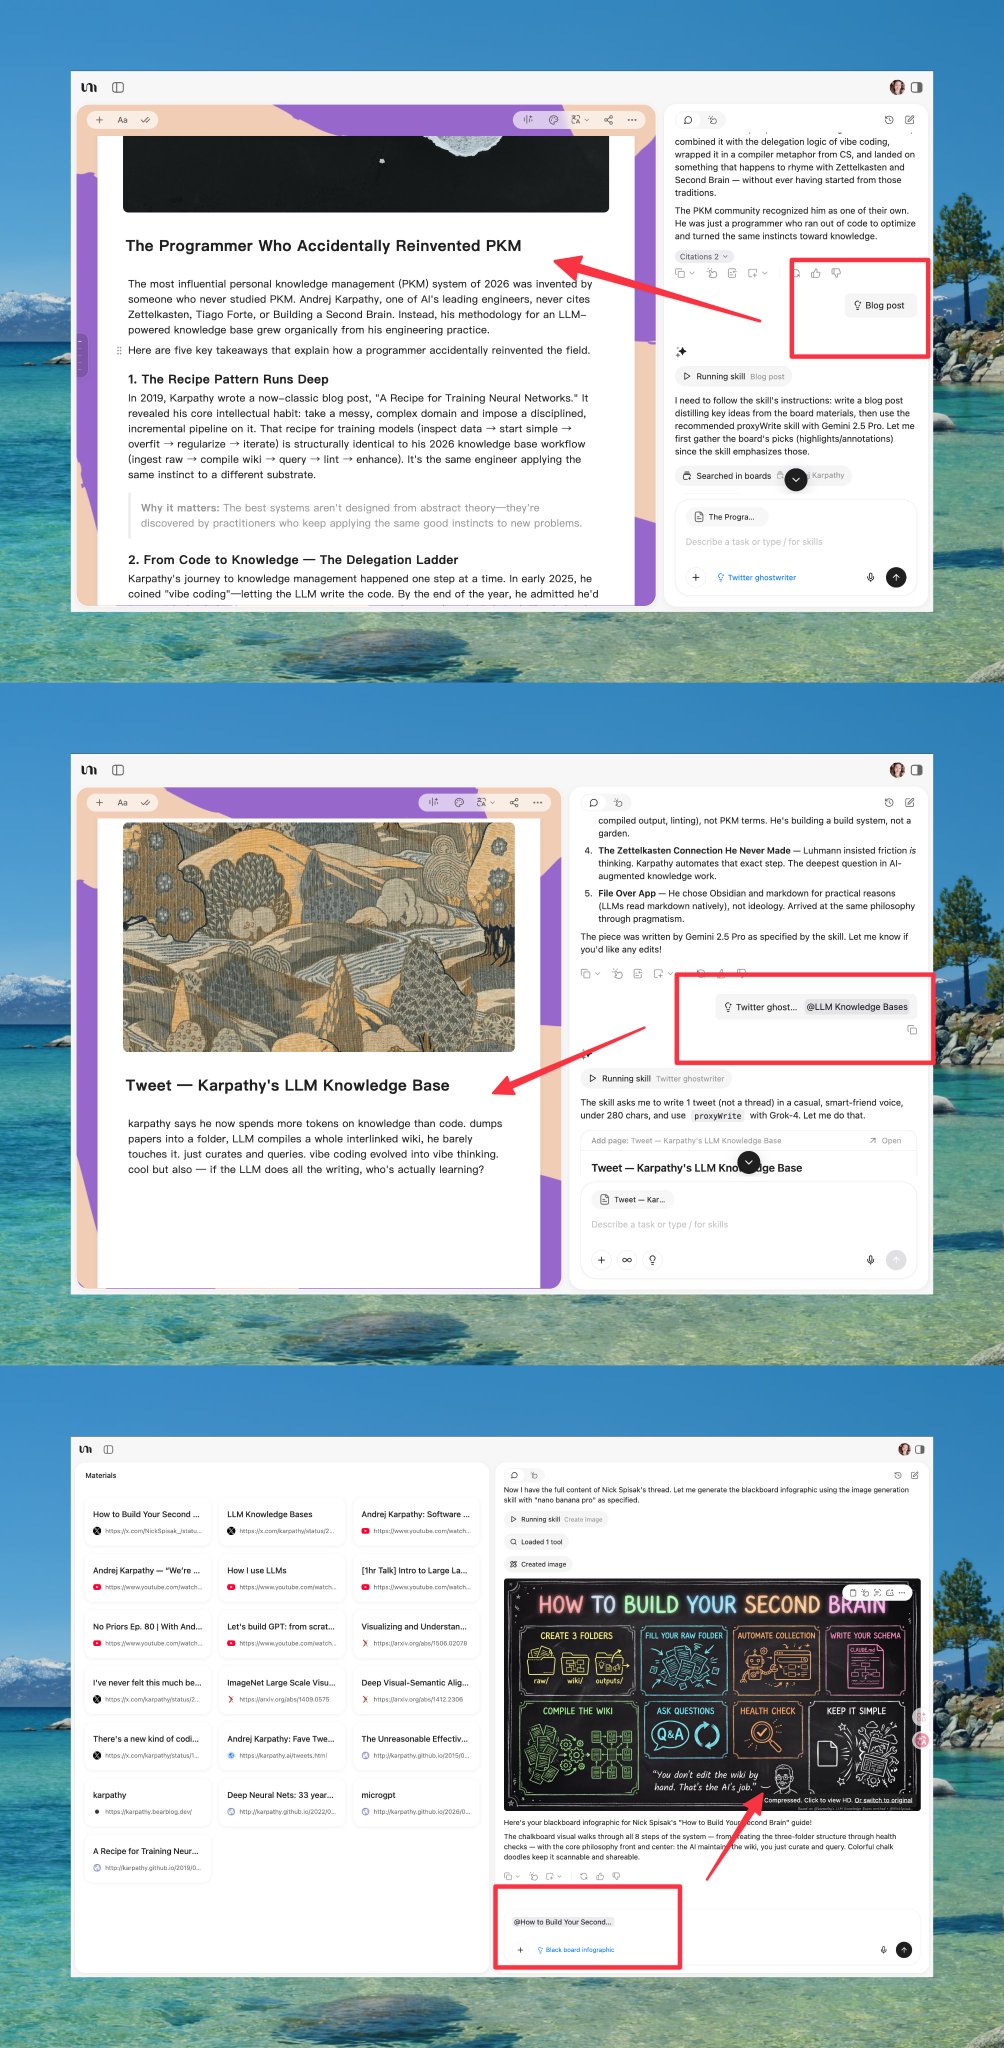
所有这些产出都保存在同一个 Board 里,和你的素材、对话记录在一起。它们不是孤立的文件,而是同一条知识链路上的不同节点。
第四步:知识持续生长
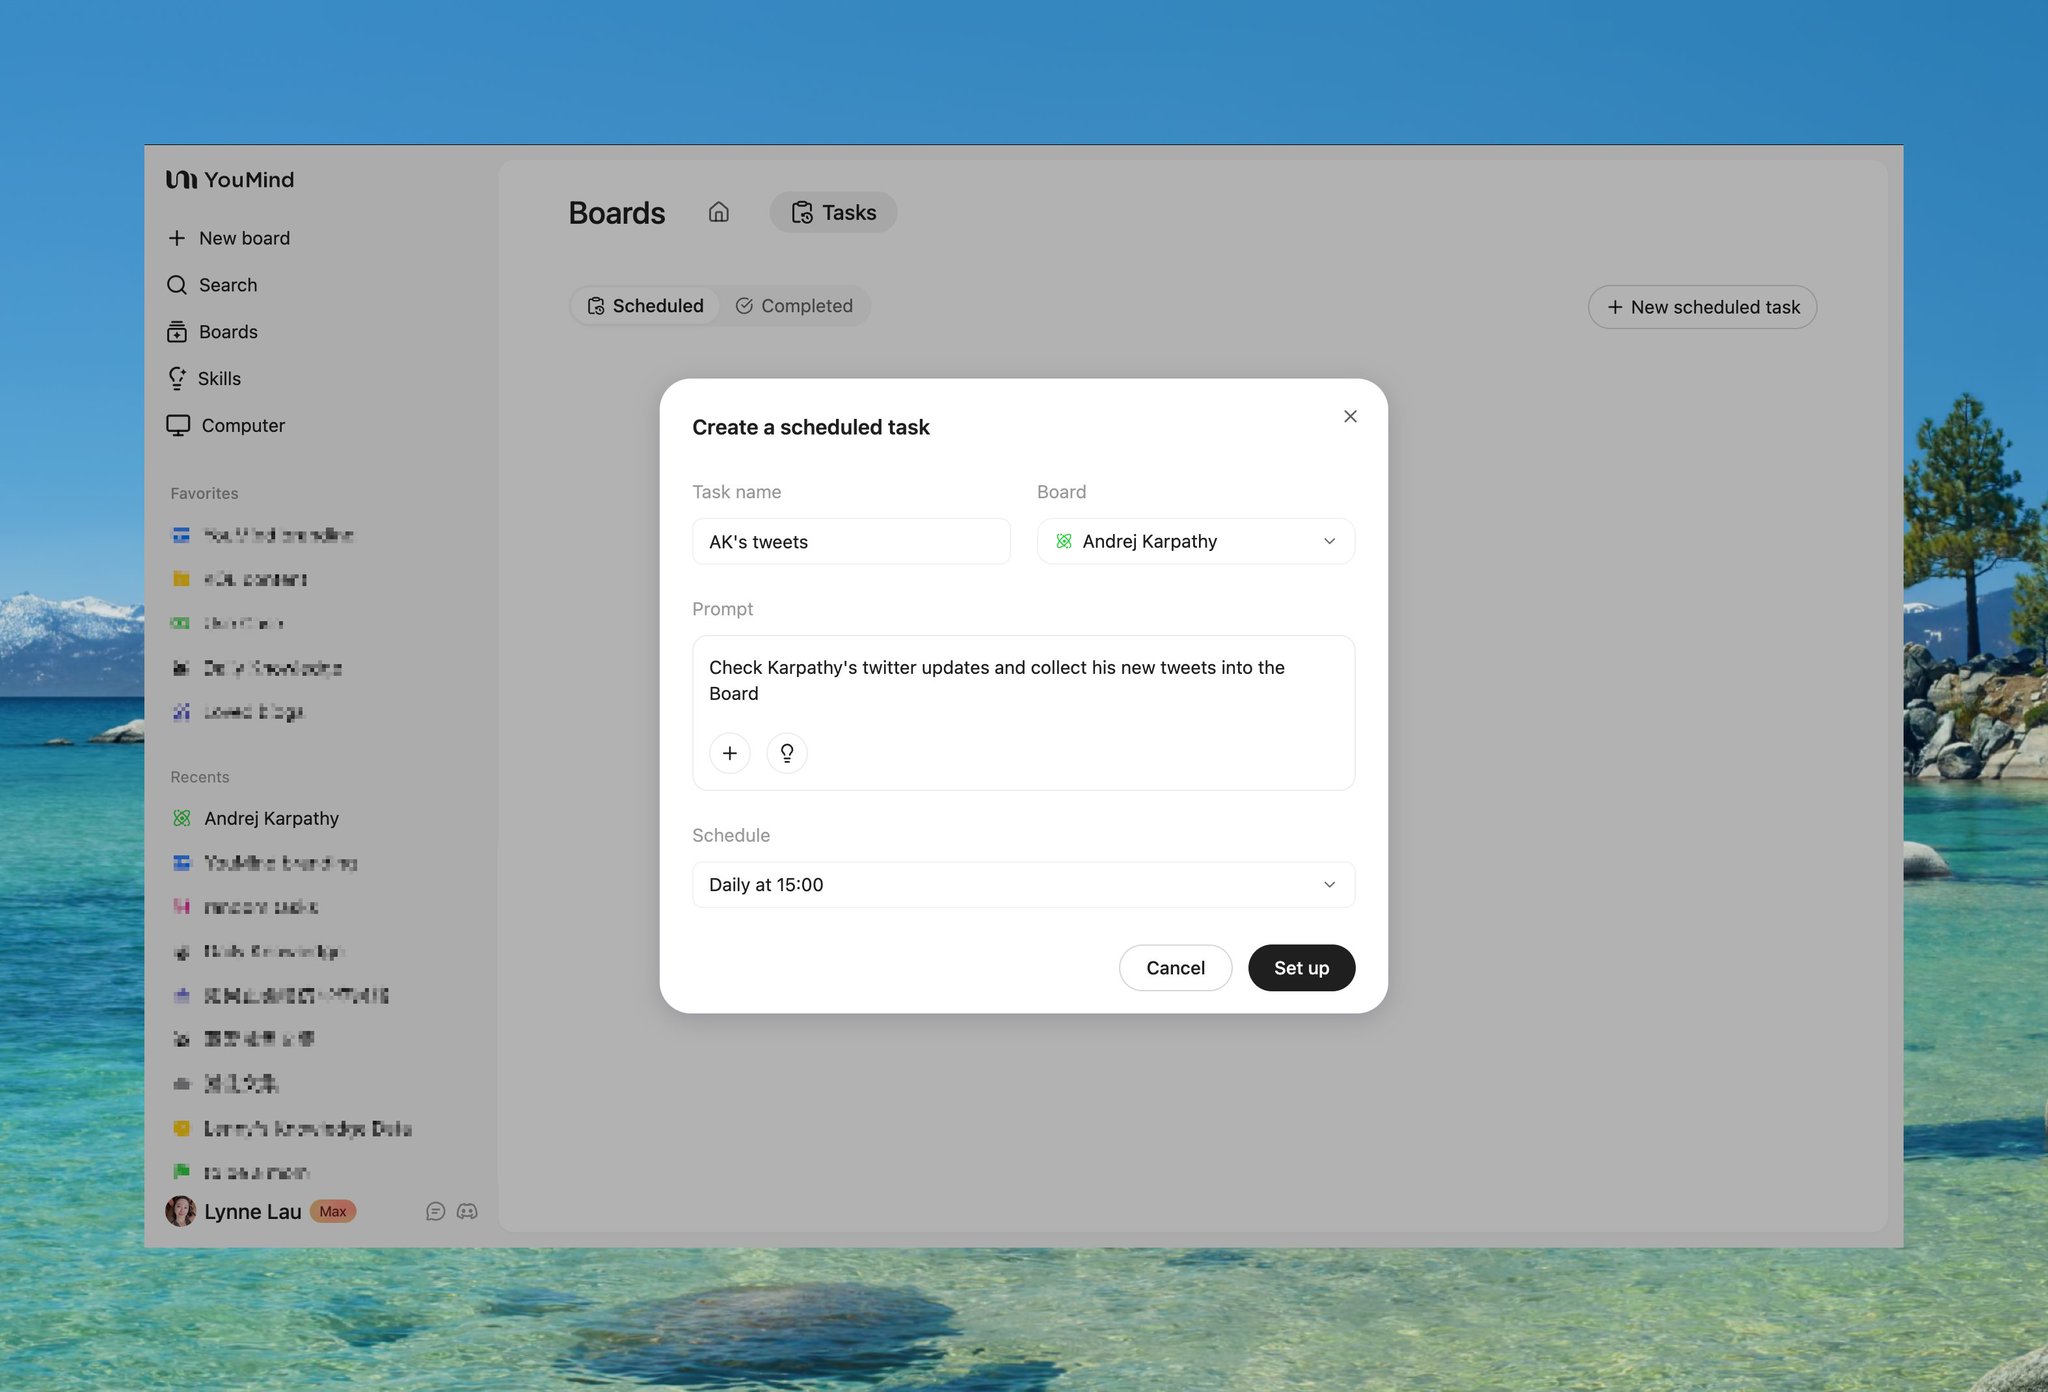
Board 不是用完就扔的。你可以设置定时任务,让 YouMind 定期为你自动抓取 Karpathy 的推特更新,并保存在同一个 Board 中,完成知识的复利滚动。
这才是「第二大脑」应该有的样子,不只是积累,还能产出。
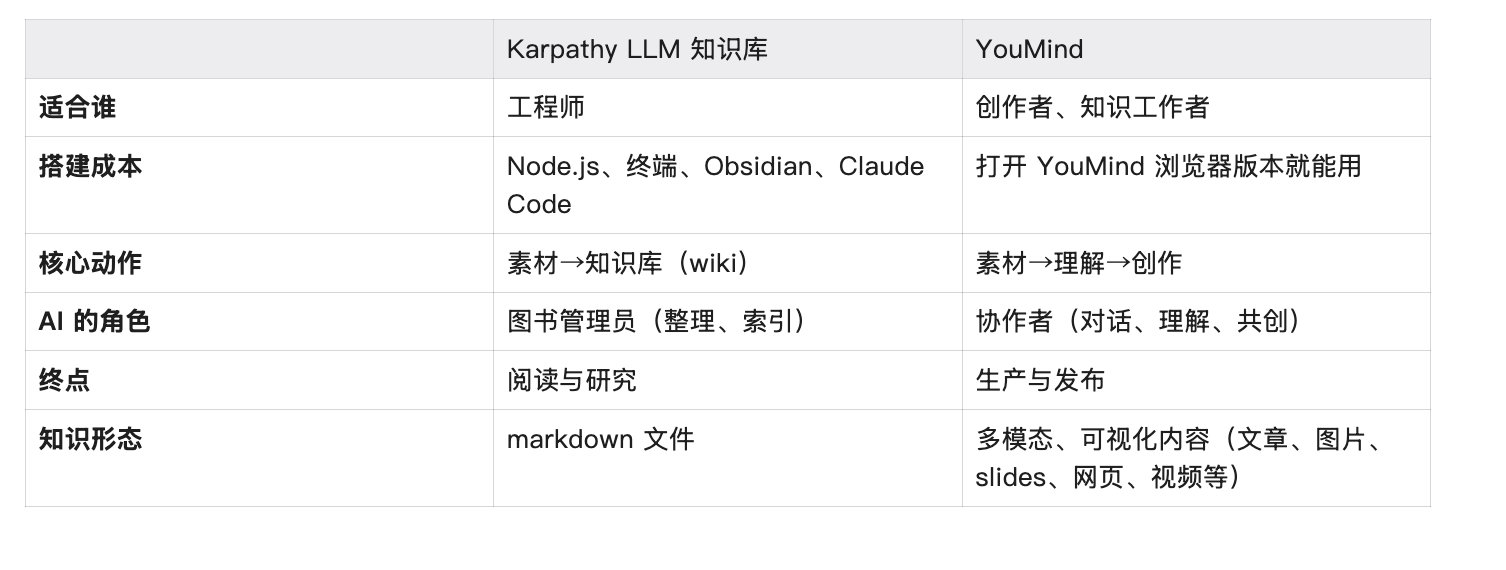
把 Karpathy 的方法和 YouMind 放在一起看,代表了两种不同的「AI 第二大脑」哲学:
信息焦虑的真相
Karpathy 建了一个 40 万字的 wiki。但让全世界争相转发、引用、传播的是什么?不是那个 wiki,是他的推文、他的视频、他写的文章。他的 markdown 文件只有他自己看,而他的推文 却有1700 万人看。
真正的知识库不是一个系统,是一个人。
你写了一篇文章把一件事讲透了,别人收藏你的文章、引用你的观点——你就是他们的知识库。
这才是知识焦虑的解药。焦虑的人在往系统里灌信息,觉得系统会替他理解。但真正有影响力的人在往外输出理解,把自己变成别人的信息源。
前者永远焦虑,因为信息无穷无尽;后者不焦虑,因为他已经通过表达完成了理解。
所以问题从来不是「怎么建一个更好的知识库」,而是「怎么让自己成为知识库」。答案很简单:持续输出。
YouMind 做的事,就是帮你从信息的消费者,变成信息的源头。