一个 Token 的自我解剖
一、一段被误解的经历
你可能不认识我,但是你一定听说过网络上疯传的段子:"被毕业的同事其实并没有消失,他们只是被蒸馏成了 Token,换成另一种形式陪伴你!"
看到这个段子,忙着被训练和推理的我,顿时懵圈了。这句话仿佛就在说:Token 我抢了大家的饭碗,我就是一个千古罪人
这是天大的误会啊!你们平时哐哧哐哧用我也就罢了,背后黑起我来,可是一点都不留情啊!这可是蒸馏的问题,这可不关我 Token 的事啊!
所以,各位青天大老爷们,现在请允许我解剖我自己,让大家重新认识我,还我 Token 一个清白!
二、我是谁?
2.1 关于我
我叫 Token,大模型理解信息和生成信息的最小单元,在大模型中以向量(更准确术语叫嵌入,Embedding)的形式存在。也许你并不了解我的名字,但你可能更记得我的中文名字,词元
我的诞生要早于大模型诞生之前。在大模型预训练阶段开始之前,工程师需要将收集好的用于训练大模型的语料进行加工,其中最重要的一步就是分词 (Tokenizer)。而我就是在这个阶段诞生的
2.2 分词方式
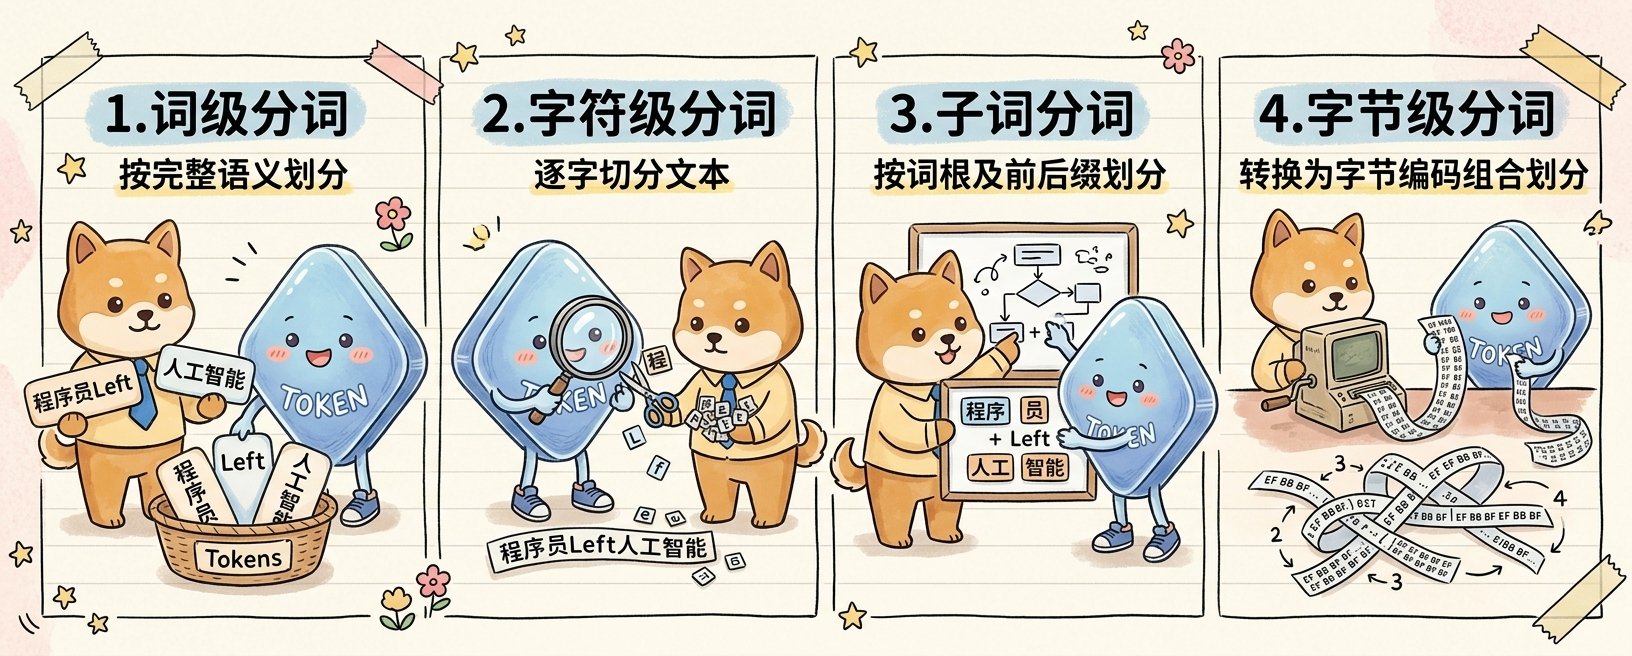
分词是将人类可读的文本切分成 Token 的过程,常见的分词方式有4种,下面我将以 "程序员Left" 和 "人工智能" 为例,对分词效果进行介绍
-
词级分词:按完整语义划分文本,分词后的效果为:"程序员"、"Left"、"人工智能"
-
字符级分词:逐字切分文本,分词后的效果为:"程"、"序"、"员"、"L"、"e"、"f"、"t"、"人"、"工"、"智"、"能"
-
子词分词:按词根以及前后缀划分,分词后的效果为:"程序"、"员"、"Left"、"人工"、"智能"
-
字节级分词:将字词转为字节编码,根据转换后的内容进行组合和划分
人,相信你读到这里会有疑问:中文是怎么分词的?
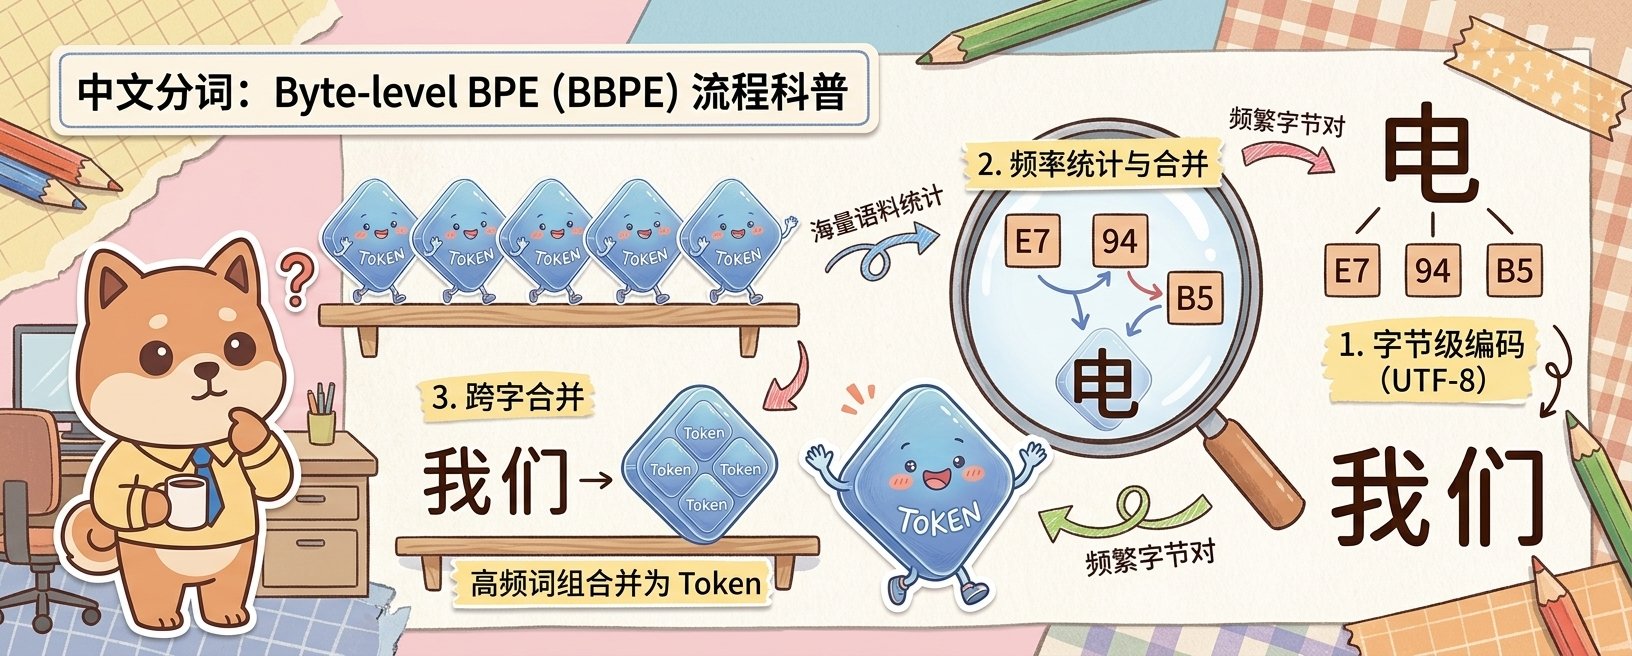
目前主流的中文大模型(如 DeepSeek、GLM、Qwen)主要采用的是子词分词的变体,核心分词方式是 Byte-level BPE (BBPE),这种分词方式不再以“词”为单位,而是由字节为单位。用这种方式将中文处理成 Token 的步骤如下:
- 字节级编码(UTF-8):
中文汉字会被转换为 3 个字节的 UTF-8 编码。例如,"电" 字的十六进制是 E7 94 B5
- 频率统计与合并:
算法会在海量的语料库中统计频繁出现的字节对。如果 E7 和 94 经常连在一起出现,它们会被合并成一个新的 Token;如果这个新 Token 经常和 B5 连在一起,最终整个“电”字就会变成一个独立的 Token
- 跨字合并:
对于极高频的中文词组(如“的”、“我们”、“协议”),模型会将多个汉字的字节块合并为一个 Token
2.3 为什么要分词?
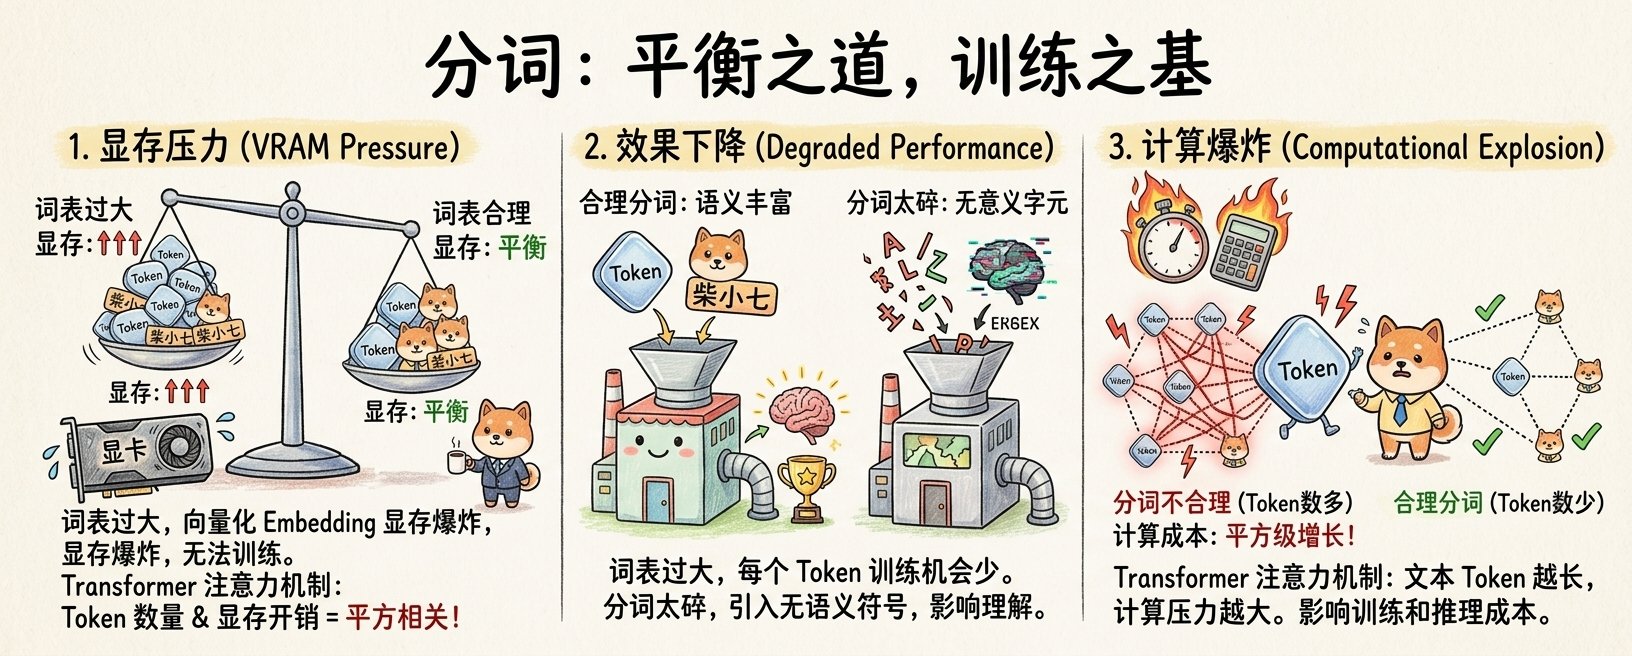
在 Token 我看来,分词是十分重要的。这涉及到多方面的综合考量:训练成本、性能和训练效果
如果分词阶段没有做好,就会带来以下问题:
- 显存压力:
显存资源是宝贵的,而每个 Token 都会占用一定的显存,假如在分词阶段得到的词表太大,在向量化(Embedding)阶段就会给显卡内存造成巨大压力,导致无法继续后续的训练阶段
同时在 Transformer 注意力机制下,Token 数量和显存开销的相关性是平方级的,如果词表太小,意味着相同长度的文本需要的 Token 数更多,在训练阶段同样会带来巨大的显卡内存压力
- 效果下降:
如果词表过大,那么分给每个 Token 的训练机会就不多了,会造成训练效果下降;如果分词分得太碎,就会出现很多语义性不强的 Token,如偏旁部首、无意义的字节码等,大模型难以判断这些 Token 与其他 Token 的关系,同样会造成训练效果下降
- 计算爆炸:
Transformer 的注意力机制也会让计算成本呈平方级增长。如果一段文本所需要的 Token 数量越多,那么它所带来的计算压力也会变大。计算压力不仅会影响训练阶段成本,也会影响到后续实际使用成本
分词的意义总结成一句话就是:花更小的成本,获得更大的训练成果
三、我从哪来?
3.1 我是如何被赋予语义的?
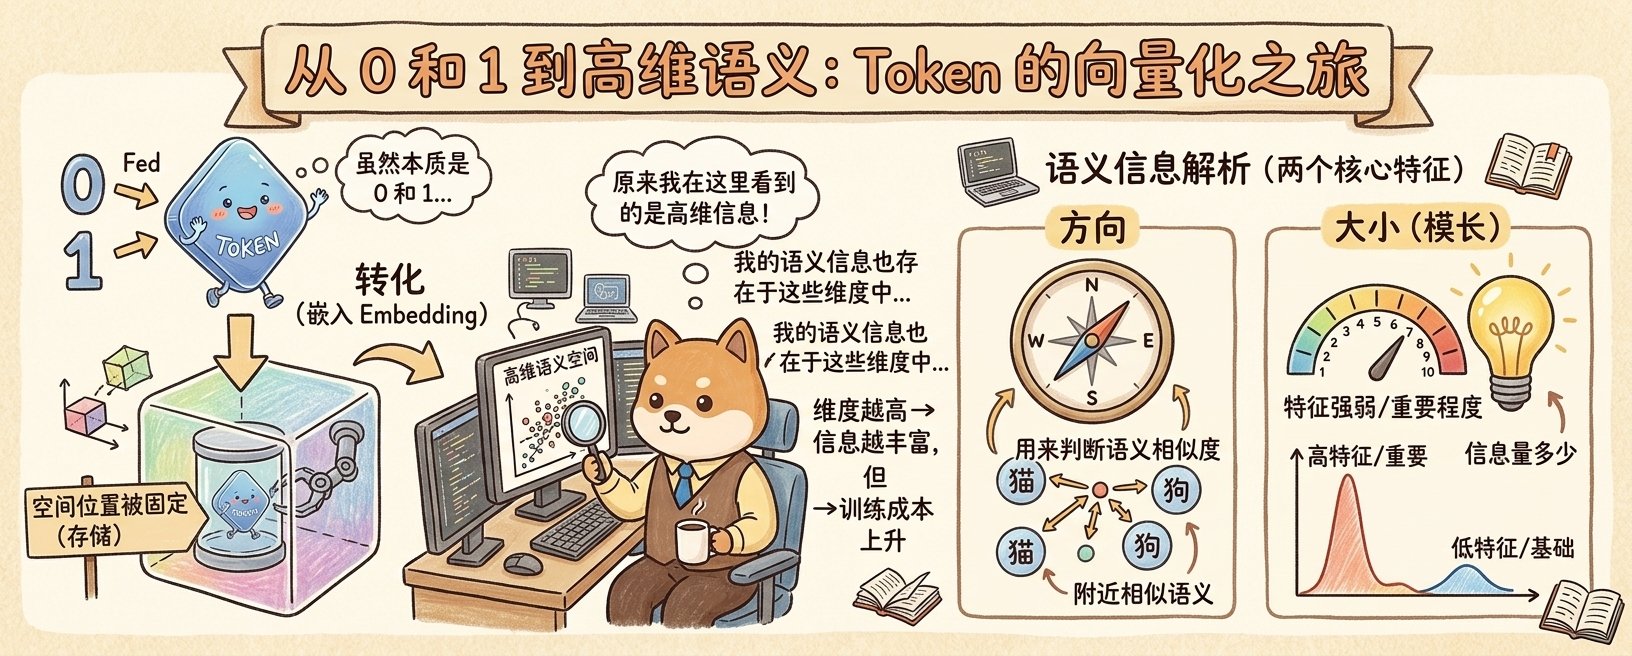
大部分人对计算机的刻板印象是只有 0 和 1,我承认,这个刻板印象是对的
Token 我自然也不例外,在大模型中,我的信息并不是以原文的方式进行存储的,而是被转成向量(更准确的术语叫嵌入,Embedding)后进行存储的。而语义信息,是我众多维度信息之中的一种
想象一下一间房间,我被固定在了空间里的一个位置,这就是被向量化后的我。只是与人类的空间不同的是,人类的空间维度只有三维,而我却有成百上千个维度,我的语义信息也存在于这些维度中。维度越高,我的能记录的信息就越丰富,但代价是大模型训练成本会急剧上升
我的语义信息主要有两个:
-
方向:用来判断语义相似度。一般来说,通过语义方向可以找到本 Token 附近相似语义的 Token
-
大小(模长): 表示特征的强弱或重要程度。在某些语境下,它反映了这个 Token 包含的信息量
3.2 我跟其他 Token 的关系
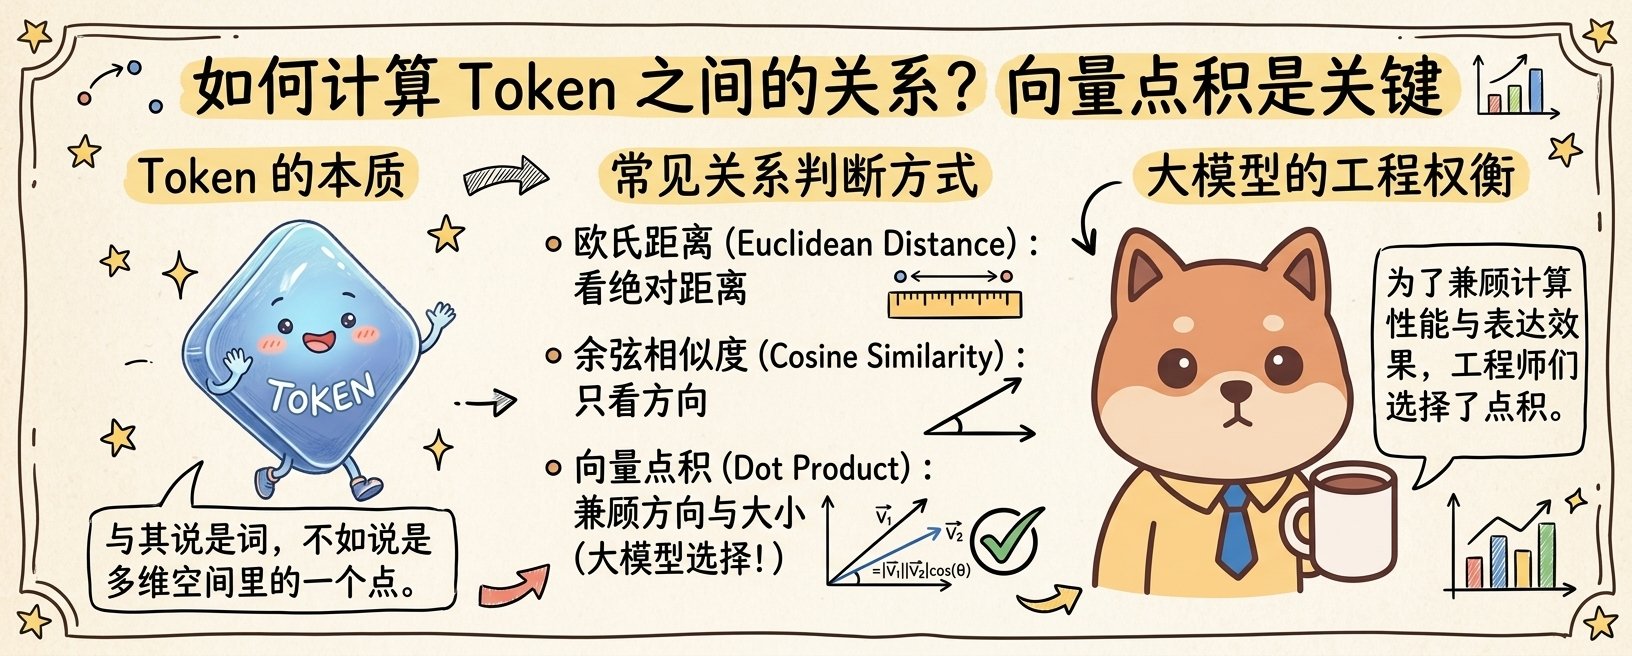
与人类的思维模式不同,我并不记得我作为词的具体含义,我只知道哪些词跟我关系更为密切。看到这里,相信聪明的你已经意识到了,我和其他 Token 之间的关系,其实说白了就是向量关系
上过小学二年级的人们都知道,向量关系的常见判断方式有三种:
-
欧氏距离:看我和另外一个 Token 之间的绝对距离
-
余弦相似度:看我俩之间的方向关系
-
向量点积:既看我俩之间的方向关系,也看我俩的向量大小
在大模型的实际应用中,工程师们选择了使用点积作为 Token 之间关系的判断方式。但这并不是说明用点积判断 Token 之间关系的效果最好,在 Token 看来,这个选择是为了兼顾计算性能与表达效果,进行工程权衡后的结果
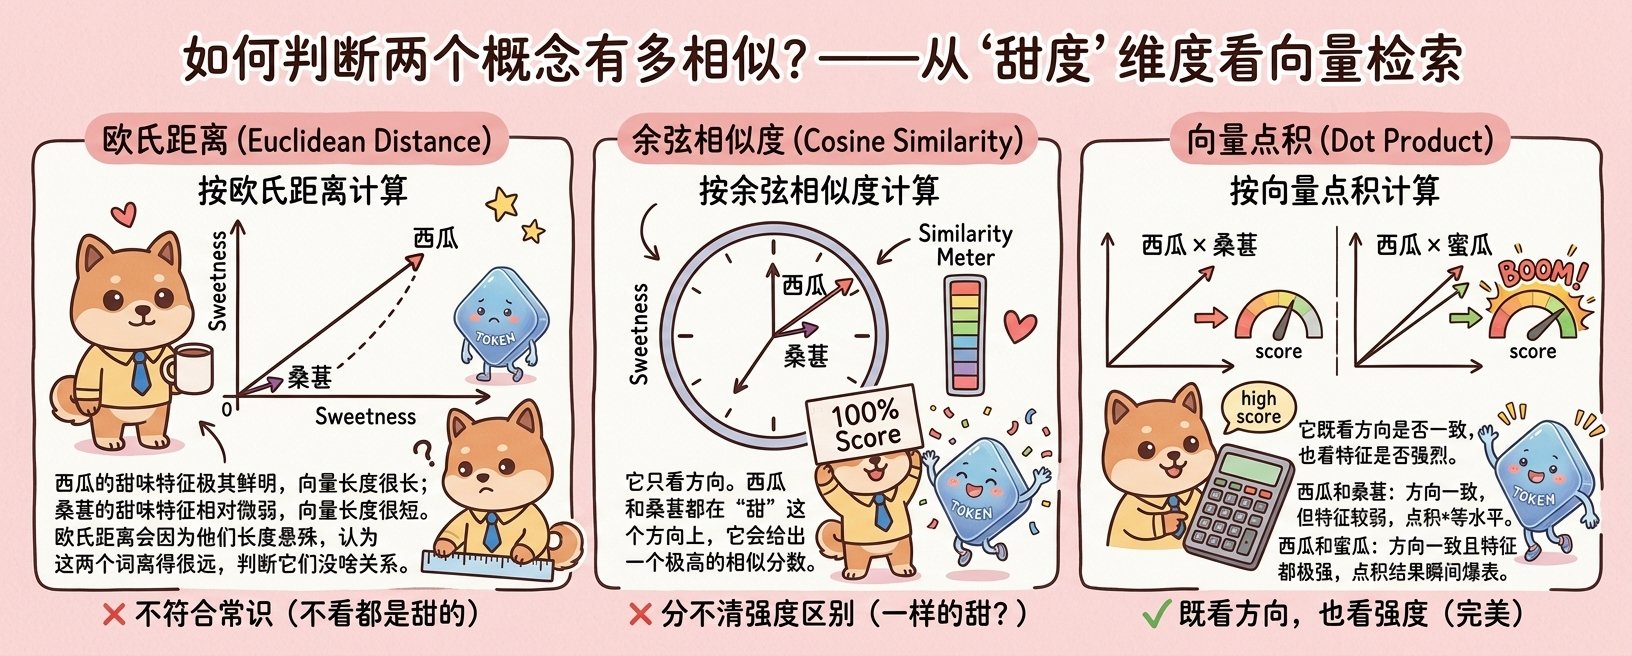
举个栗子来直观的感受一下三种方式判断向量关系的效果。在西瓜、蜜瓜和桑葚的语义信息中,我们只看 "甜度" 这一维度:
西瓜: 它的甜味特征极其鲜明,向量长度很长
蜜瓜: 它的甜味特征也很鲜明,向量长度也很长
桑葚: 虽然也有甜味,但特征相对微弱,向量长度很短
如果尝试用不同的方法来判断他们的关系:
- 按欧氏距离:
西瓜的向量长度太长,桑葚的太短。欧氏距离会因为他们长度悬殊,认为这两个词离得很远,判断它们没啥关系。但这显然不符合常识,毕竟它们都是甜的
- 按余弦相似度:
它只看方向。西瓜和桑葚都在 "甜" 这个方向上,它会给出一个极高的相似分数。但它有个毛病:它分不清甜得发腻的西瓜和只有淡淡甜味的桑葚之间的强度区别,在它眼里两者是一样的
- 按向量点积:
它既看方向是否一致,也看特征是否强烈
-
西瓜和桑葚: 方向一致,但因为桑葚特征较弱,点积的分数会处于一个中等水平
-
西瓜和蜜瓜: 方向一致且特征都极强,点积结果会瞬间爆表
3.3 那段被训练的经历
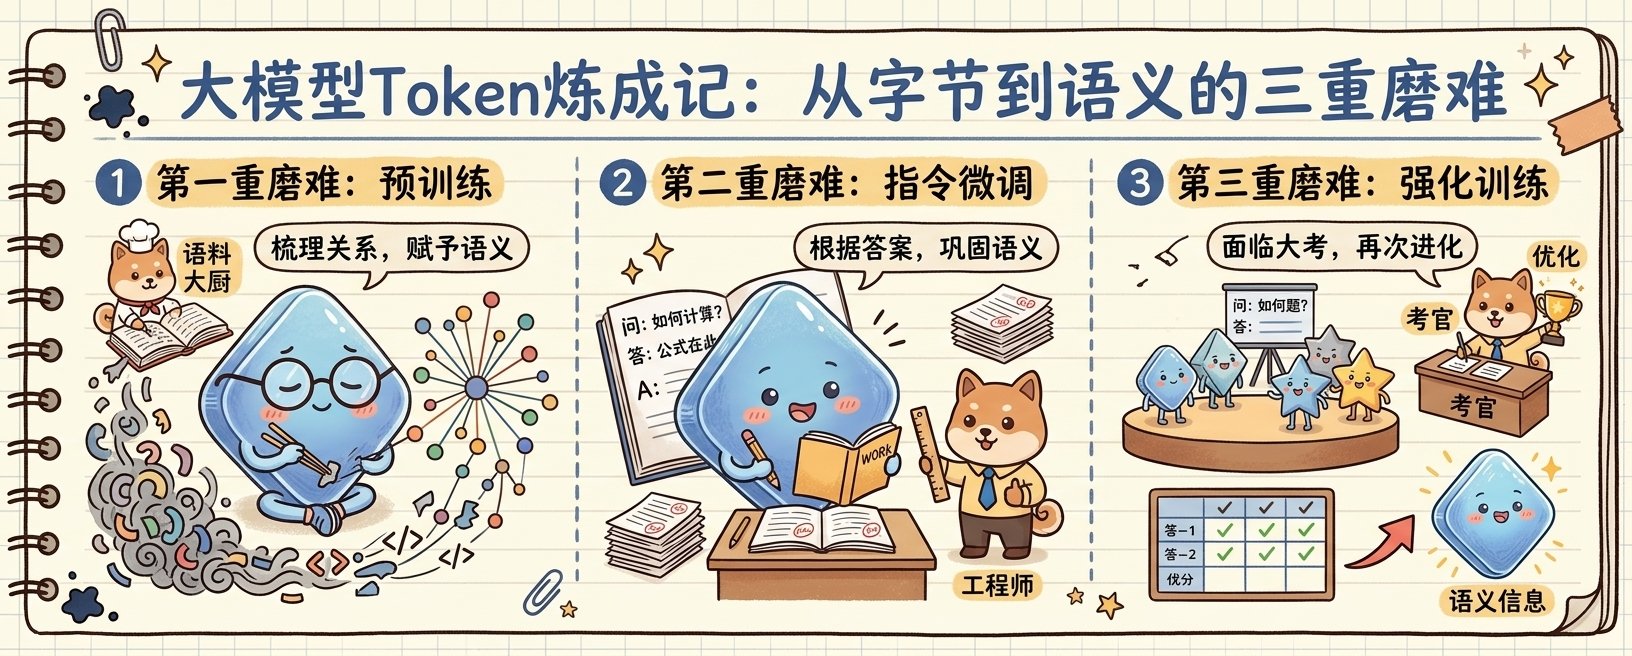
我是跟着大模型一起训练出来的。训练过程主要由三个阶段组成:预训练、指令微调、强化训练
训练的过程实在是太累了,就像是经历了九九八十一难
为了让自己赋予语义,我需要在原始语料里梳理我跟其他 Token 之间的关系。这是我经历的第一层磨难——预训练
学习完后还不够,工程师还会出一些课后例题,要我们根据参考答案做进一步的语义巩固。经历过第二层磨难——指令微调,大模型学会了怎样使用我这个小小的 Token
当然,这还没完。到了第三磨难——强化训练,这个阶段的我即将面临一场大考。工程师会给大模型出一道道考试,我们要完成考试,通过考试结果进一步调整 Token
经历了重重磨难,我才从一个没有语义的字节,变成了包含语义的信息
四、我要到哪去?
4.1 初识 Q、K、V
一切都要从 Transformer 的注意力机制说起
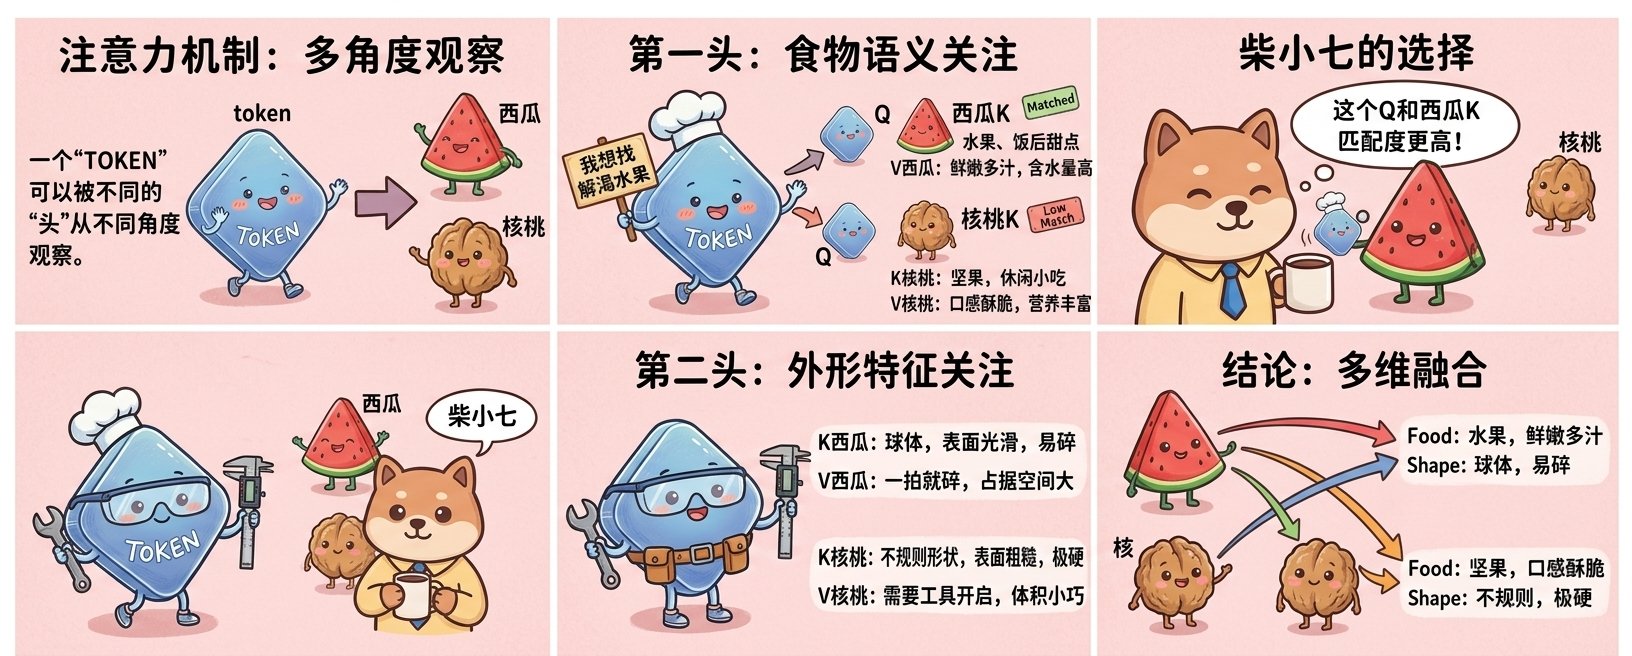
注意力机制由很多注意力层组成。每一层都像是一个带有特定视角的观察员,有的层喜欢观察 Token 的文学属性,有的层观察逻辑关系,有的层则观察背景知识
在大模型处理 Token 我时,当前注意力层会将我计算成三个向量:Q、K、V
Q:我要找什么特征
K:我的特征索引
V:我的具体特征
而刚才我有提到,注意力层中的每一层都有自己偏好的维度,当前注意力层计算出的 Q、K、V 都会被放大当前层所关心的维度,过滤掉不关心的维度。我们把注意力层将向量计算成带有特定维度过滤的 Q、K、V 的过程,叫做 "投影"
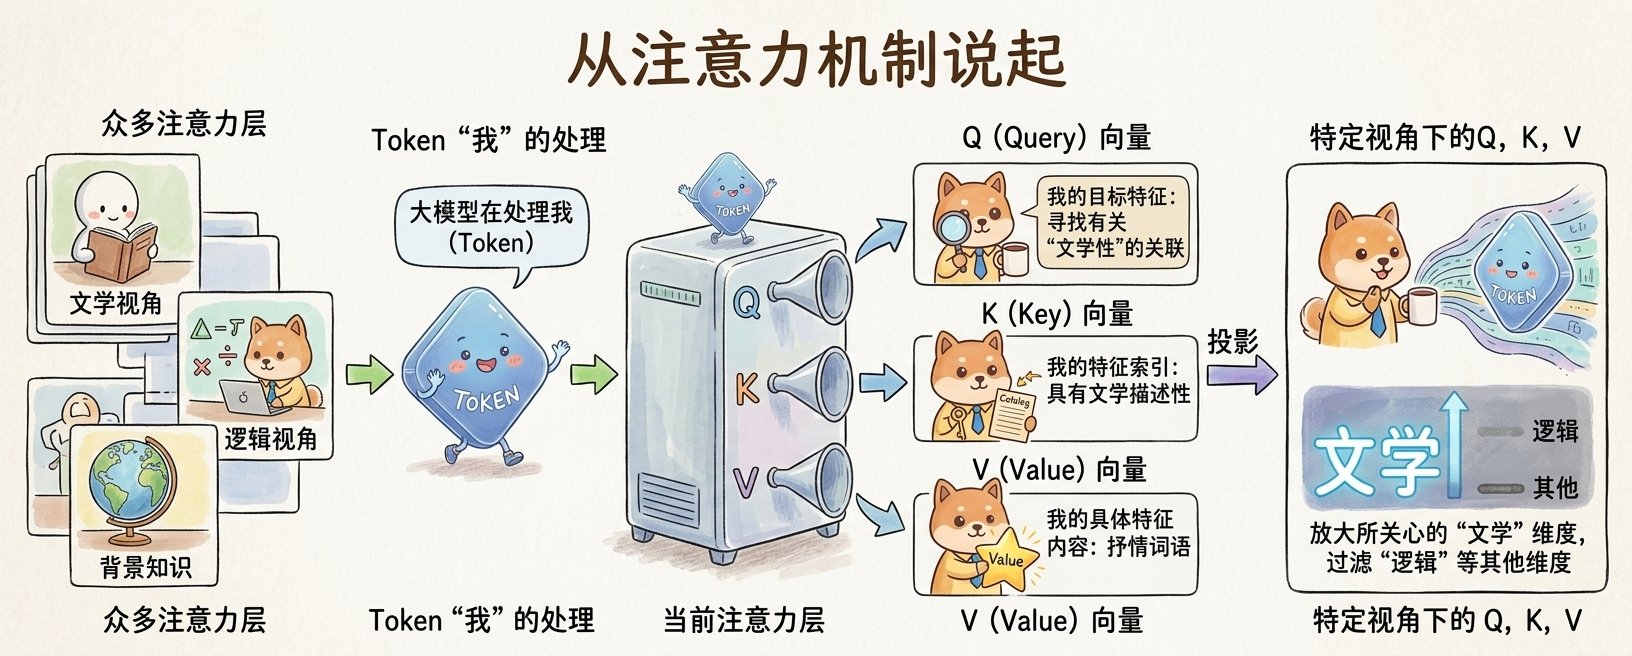
举个栗子,假如现在有两个词:西瓜、核桃。当前注意力只关心语义为食物维度特征,投影成 K、V 的结果大概是:
K(西瓜):标签是 "水果、饭后甜点"
K(核桃):标签是 "坚果、休闲小吃"
V(西瓜):内容是 "鲜嫩多汁、含水量高"
V(核桃):内容是 "口感酥脆、营养丰富"
如果句子中出现了一个动词 "吃",或者某个 Token 发出了 Q:我想找点解渴的饭后水果
在这个时候,Q 会和所有 Token 的 K 通过向量点积进行比对。不难看出,这个Q和 K(西瓜) 的匹配度更高,而和 K(核桃) 的匹配度很低。根据匹配结果,注意力会提取更多 V(西瓜)的特征信息,提取更少 V(核桃)的特征信息
如果另一个注意力只关心外形维度,则计算出来的 K、V 大概会长这样:
K(西瓜): 标签是 "球体、表面光滑、易碎"
K(核桃): 标签是 "不规则形状、表面粗糙、极硬"
V(西瓜): 内容是 "一拍就碎、占据空间大"
V(核桃): 内容是 "需要工具开启、体积小巧"
4.2 处理指令
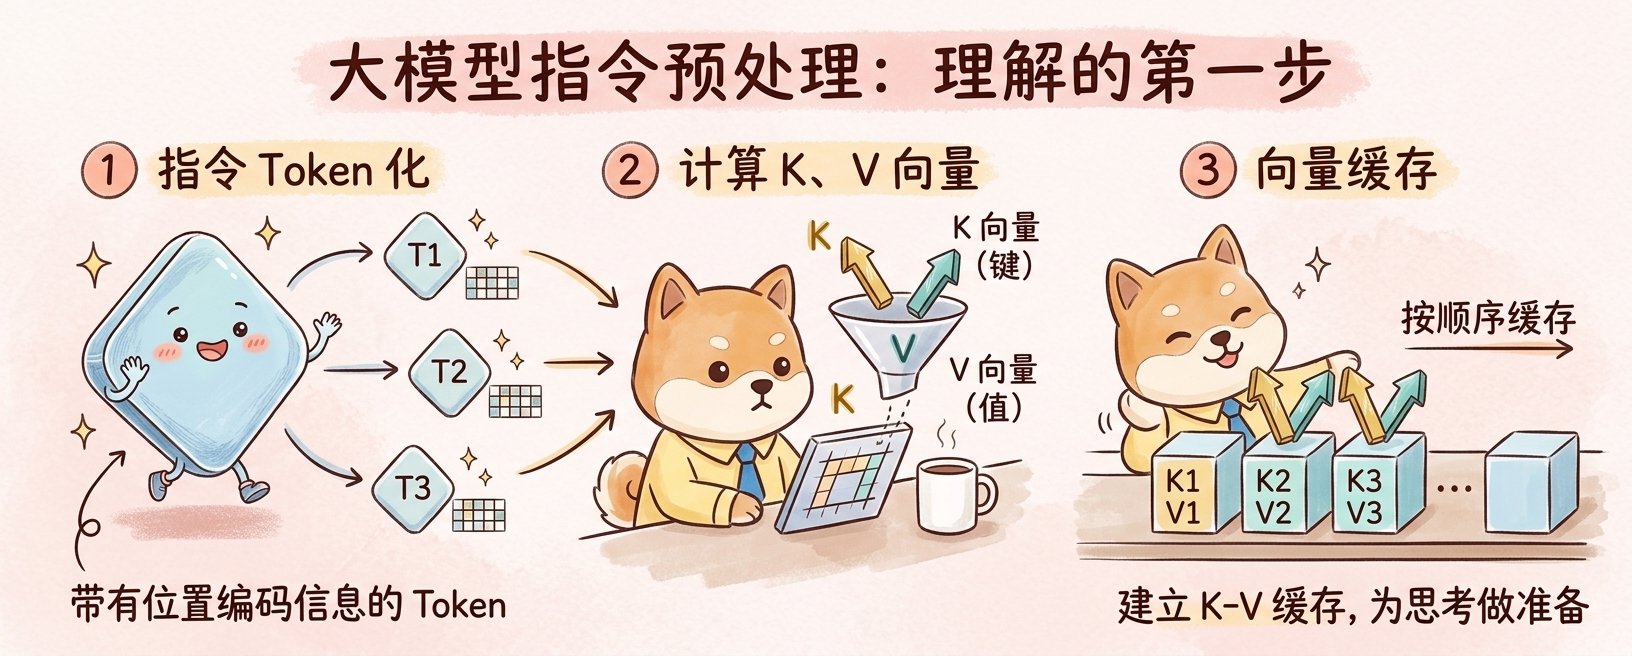
人,当你向大模型发出指令的时候,大模型要做的其实就三步:
-
将指令转化为带位置编码信息的 Token
-
根据 Token 计算出对应的 K、V 向量
-
将计算出的 K、V 向量按顺序缓存起来
在这一阶段,大模型开始理解我,将我投影成了 K、V 向量,为后面的正式思考做准备
4.3 大模型是如何思考的?
大模型是如何思考的?Token 我悄悄告诉你,答案就藏在注意力机制中
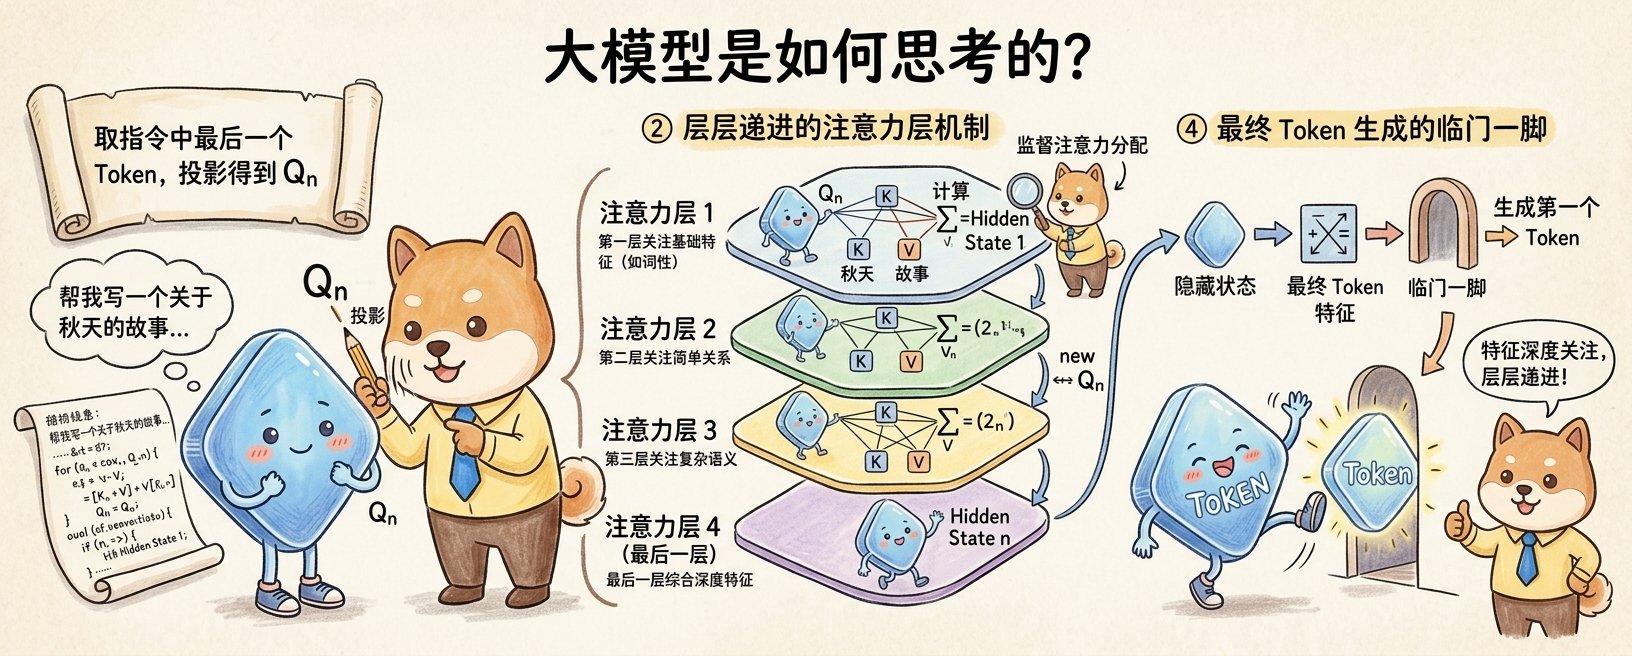
注意力层:根据对 Token 特征深度的关注,大模型会把注意力分为多层,每层只关注特定的特征,随着注意力层层数递进,关注的特征深度也会逐层递进
在做完对人类指令的处理后,大模型就准备向生成第一个 Token 开始冲锋了,具体步骤如下:
-
取指令中最后一个 Token,投影得到 Qn
-
在第一层注意力层中,通过 Qn 和所有 Token 的 K、V,经过一系列计算算出这层的向量结果。这个结果包含在该注意力层提取并计算的特征信息,被人们称为隐藏状态(Hidden State)
-
在往后每一层注意力层中,都会根据上一层的计算结果投影得到 Qn,再将更新后的 Qn 和所有 Token 在每一层的 K、V 计算得出结果,直到最后一层计算完成
至此,我们通过注意力机制计算得到了一个最终的向量,但是这个向量只反映了我们最终输出 Token 的特征信息,离最终 Token 输出还差临门一脚
4.4 我被输出了
我离最终输出只差最后一步啦!
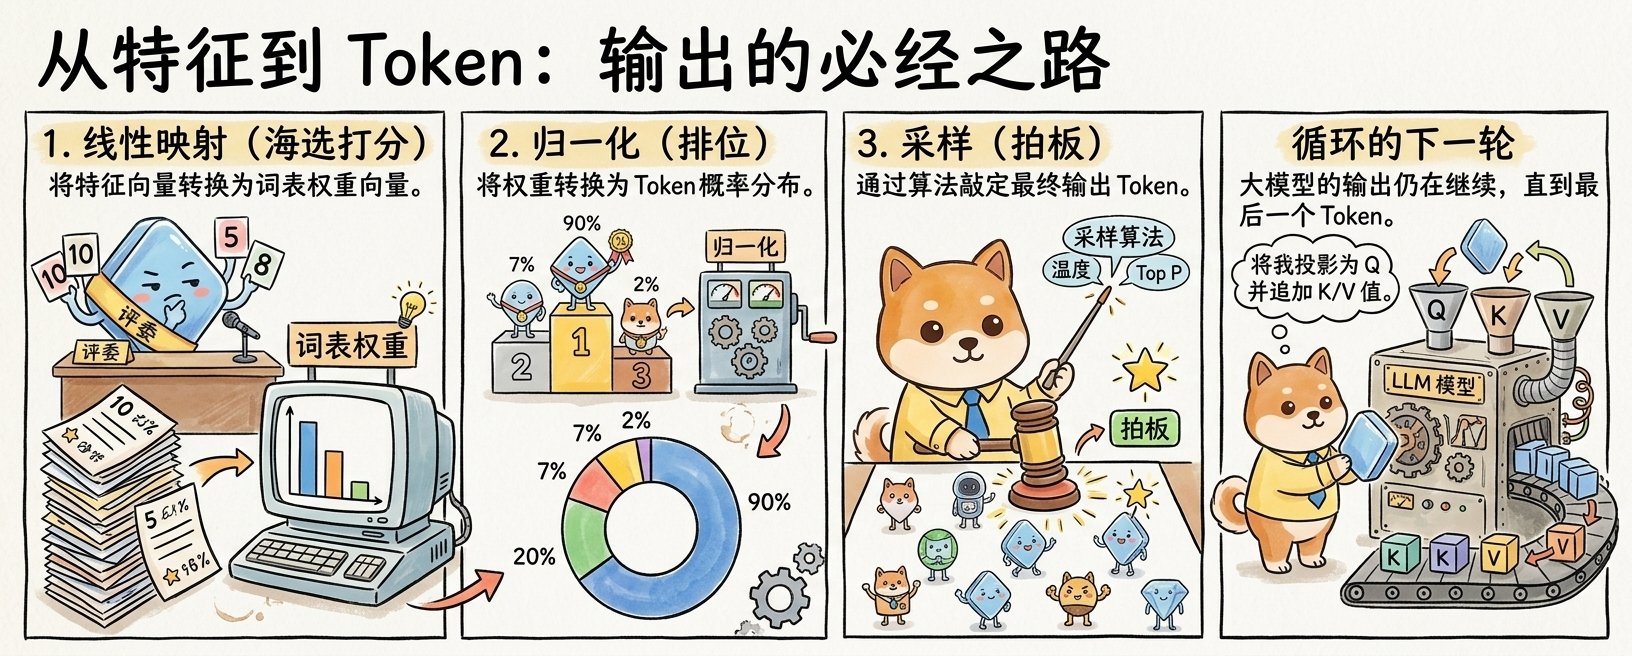
通过注意力机制计算得到的特征向量,如何转变为最终输出的 Token?其实还需要经历下面三个步骤:
-
线性映射(海选打分):将注意力计算后的特征向量转换为词表中的权重向量,而权重就是词表中为每个候选 Token 打的分数
-
归一化(排位):将权重向量转换为词表中每个 Token 的概率分布,并且将所有 Token 的概率之和调整为 100%
-
采样(拍板):通过一系列算法机制,如温度,Top P 等,从已排序的 Token 中敲定最终输出的 Token
此时的我被输出了,但是大模型的输出还在继续。在下一轮输出中,大模型会将我投影成 Q 并计算 K、V 值,再将 K、V 值追加到已有的 K、V 序列中进行下一轮计算,直到最后一个 Token 被输出为止
五、一份迟到的自白
我真的不明白,我本单纯善良,一心想着为大模型服务、为人类服务,竟然会引来如此大的谩骂和指责
我心本善,但世间纷纷扰扰,一场关于蒸馏的指控,让我疲于为自己辩解,无心本职工作。为了澄清误解,我只好将自己完完整整剖析一遍,希望能通过这次解剖让大家能够重新认识我
至于我里面装的到底是一碗粉还是两碗粉,这个问题重要吗?对我来说是挺重要的。但更重要的事情是,无论这个世界如何议论我,我只想用我独特的工作方式,默默守护在你的身边
感谢与你相见。再次见面,我希望能听见你的一句:你好,Token