Thin Harness, Fat Skills
原文:Garry Tan (@garrytan) | 2026年4月11日 翻译 & 精简版
Steve Yegge 说,用 AI 编程智能体的人比用 Cursor 和 Chat 的人高效 10x 到 100x,比 2005 年的 Google 工程师高效约 1000x。
这是真的数字。我见过。我亲历过。
但大家听到这个数字时,找错了原因。更好的模型。更聪明的 Claude。更多参数。
2x 的人和 100x 的人用的模型完全一样。区别不在于模型,在于架构——而这个架构可以写在一张索引卡片上。
The harness is the product
2026年3月31日,Anthropic 意外把 Claude Code 全部 51.2 万行源代码发布到了 npm registry。我全部读完了。
它证实了我一直在 YC 教的东西:秘诀不在于模型,而在于包裹模型的那层东西。
Live repo context。Prompt caching。专用构建的工具。Context 膨胀最小化。结构化会话记忆。并行子智能体。
这些没有一样让模型更聪明。但它们都在正确时刻给了模型正确的上下文,而没有用噪音淹没它。
那层包装叫做 harness(马具)。
每个 AI 开发者都应该问的问题是:什么放 harness 里,什么不放进去?
答案有一个特定的形状。我叫它:thin harness, fat skills。
五个核心定义
瓶颈从来不是模型的智能。模型已经知道如何推理、综合、写代码。它们失败是因为它们不理解你的数据——你的 schema,你的约定,你问题的特定形状。五个定义解决这个。
- Skill files(技能文件)
技能文件是一个可复用的 markdown 文档,教模型如何做某件事。
不是做什么——那是用户提供的。是过程。
大多数人都忽略的关键洞察:技能文件像方法调用一样工作。 它接收参数,用不同参数调用它,同一个过程产生完全不同的能力。
以 /investigate 技能为例。它有七个步骤:确定数据集范围、建立时间线、对每份文档做 diarize(后面会讲)、综合分析、论证正反两面、引用来源。它接收三个参数:TARGET、QUESTION 和 DATASET。
-
指向一位安全科学家 + 210万封发现邮件 → 获得判断举报者是否被噤声的医学研究员
-
指向一家壳公司 + FEC 竞选捐款记录 → 获得追踪协同竞选捐款的法务分析师
同一技能,同七步,同一个 markdown 文件。 技能描述的是判断过程,调用提供的是世界。
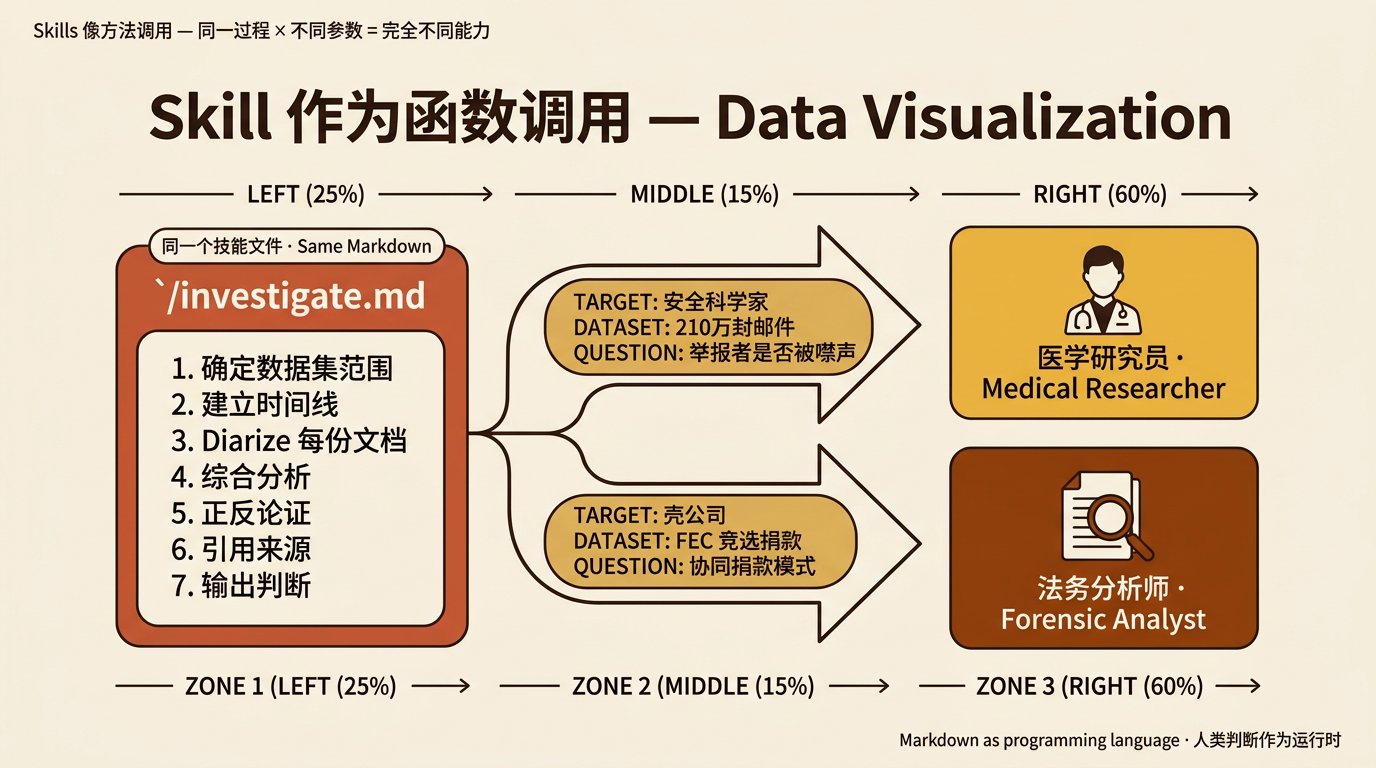
这不是提示词工程,这是用 markdown 作为编程语言、人类判断作为运行时的软件设计。Markdown 实际上比僵硬源代码更完美地封装了能力,因为它用模型本来就在思考的语言描述过程、判断和上下文。
- The harness(马具)
Harness 是跑 LLM 的程序,它做四件事:
-
在循环中运行模型
-
读写文件
-
管理上下文
-
执行安全策略
这就是"薄"的部分。
反面模式是 fat harness with thin skills(厚马具薄技能):
-
40+ 工具定义吃掉一半上下文窗口
-
2-5秒延迟的 MCP 往返
-
把每个端点都包装成独立工具的 REST API 包装器
结果是:3 倍 token、3 倍延迟、3 倍失败率。
正确做法:专用构建的工具,要快且窄。 一个 Playwright CLI 每个浏览器操作 100 毫秒完成,而不是 Chrome MCP 那样 screenshot-find-click-wait-read 要 15 秒——快 75 倍。
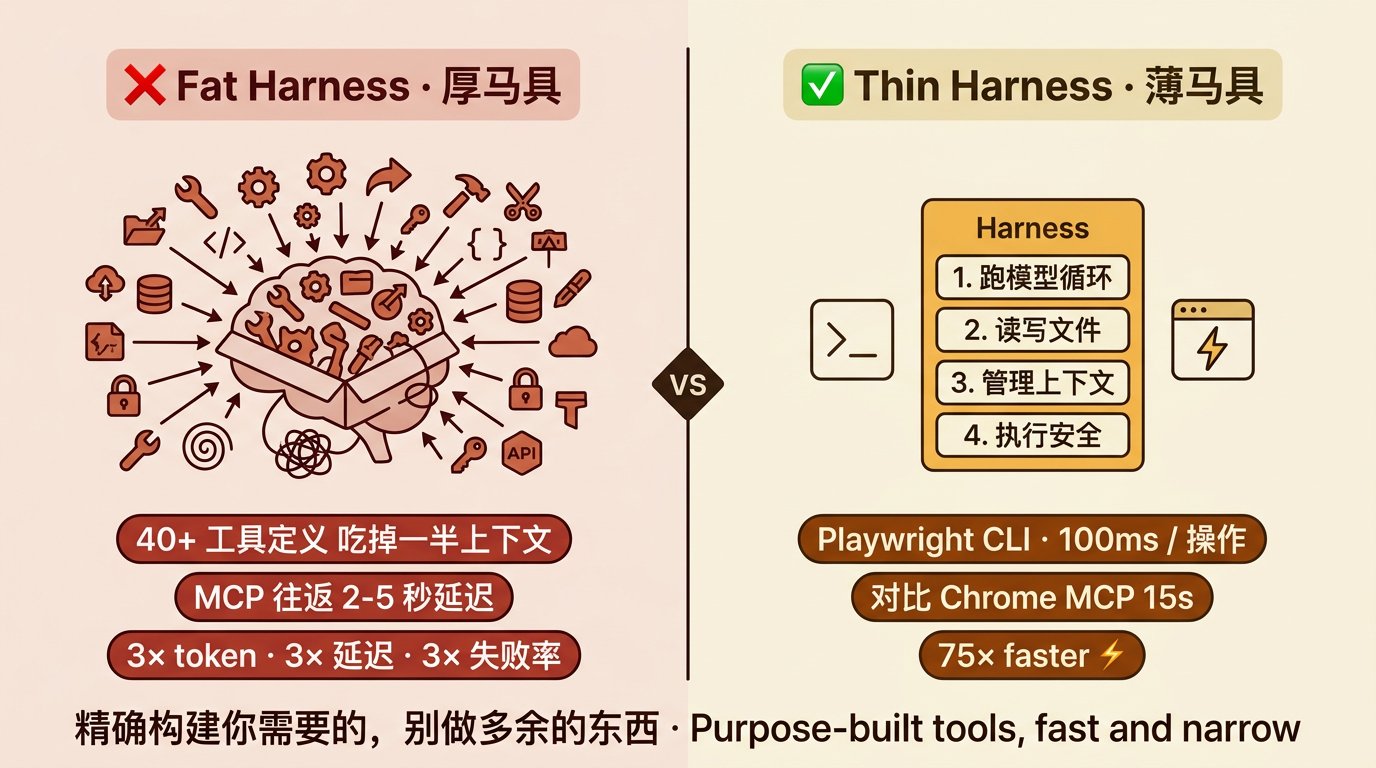
软件不需要做得太娇贵。精确构建你需要的,别做多余的东西。
- Resolvers(解析器)
解析器是上下文的路由表。
当任务类型 X 出现时,加载文档 Y。 仅此而已。
-
Skills 告诉模型怎么做
-
Resolvers 告诉模型何时加载什么
例子:开发者改了一个提示词就发布了。没有解析器的话直接上线。有解析器的话,模型先读 docs/EVALS.md——上面写着:运行评估套件、比较分数、如果精度下降超过 2% 就回滚并调查。开发者不知道评估套件存在,但解析器在正确时刻加载了正确上下文。
Garry 的自白:
我的 CLAUDE.md 曾有 2 万行。每个习惯、每个模式、每个被坑过的边缘案例,全都塞进去。模型注意力严重退化。Claude Code 甚至让我删掉一些——这说明已经过度了。
修复后只有约 200 行——只是指向文档的指针。20,000 行知识,按需加载,不污染上下文。
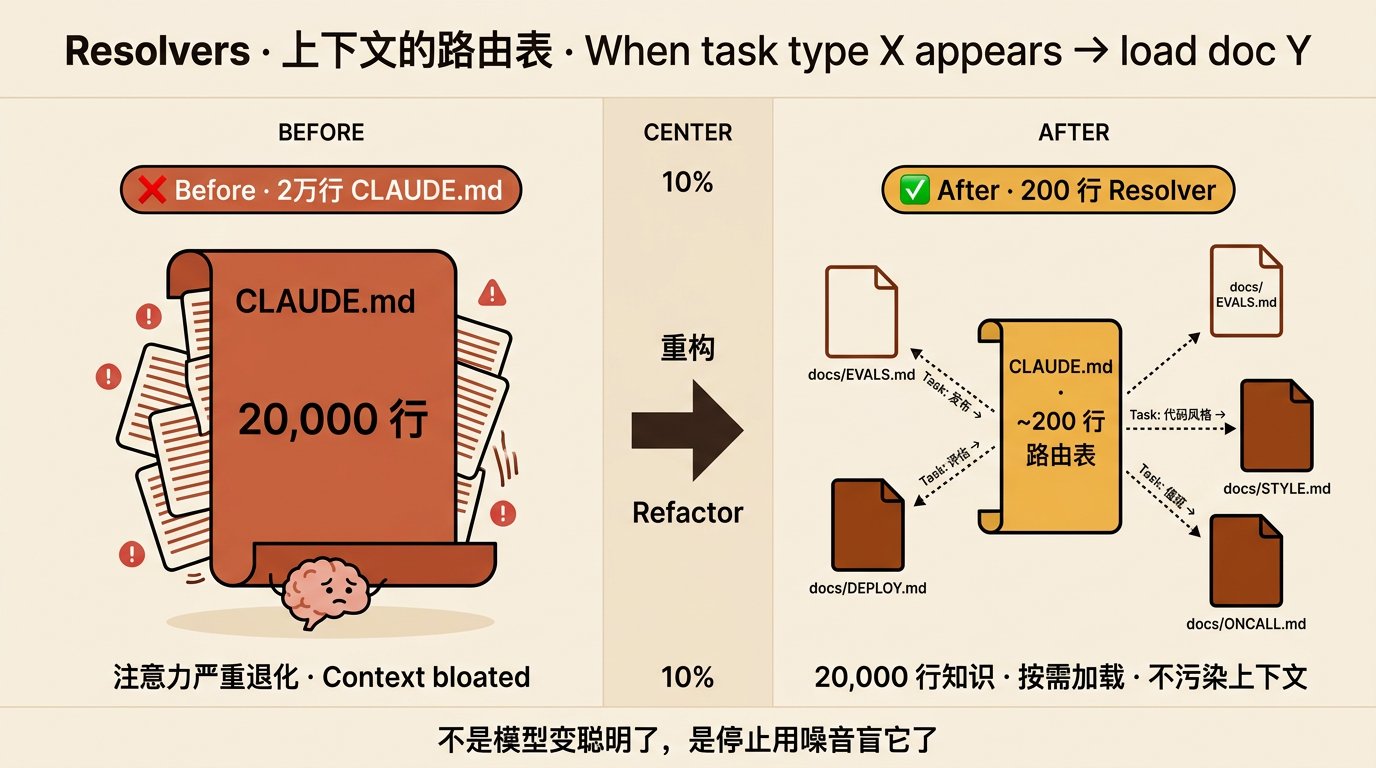
不是因为模型变聪明了,是因为我停止用噪音盲它了。
- Latent vs. Deterministic(潜在空间 vs. 确定性)
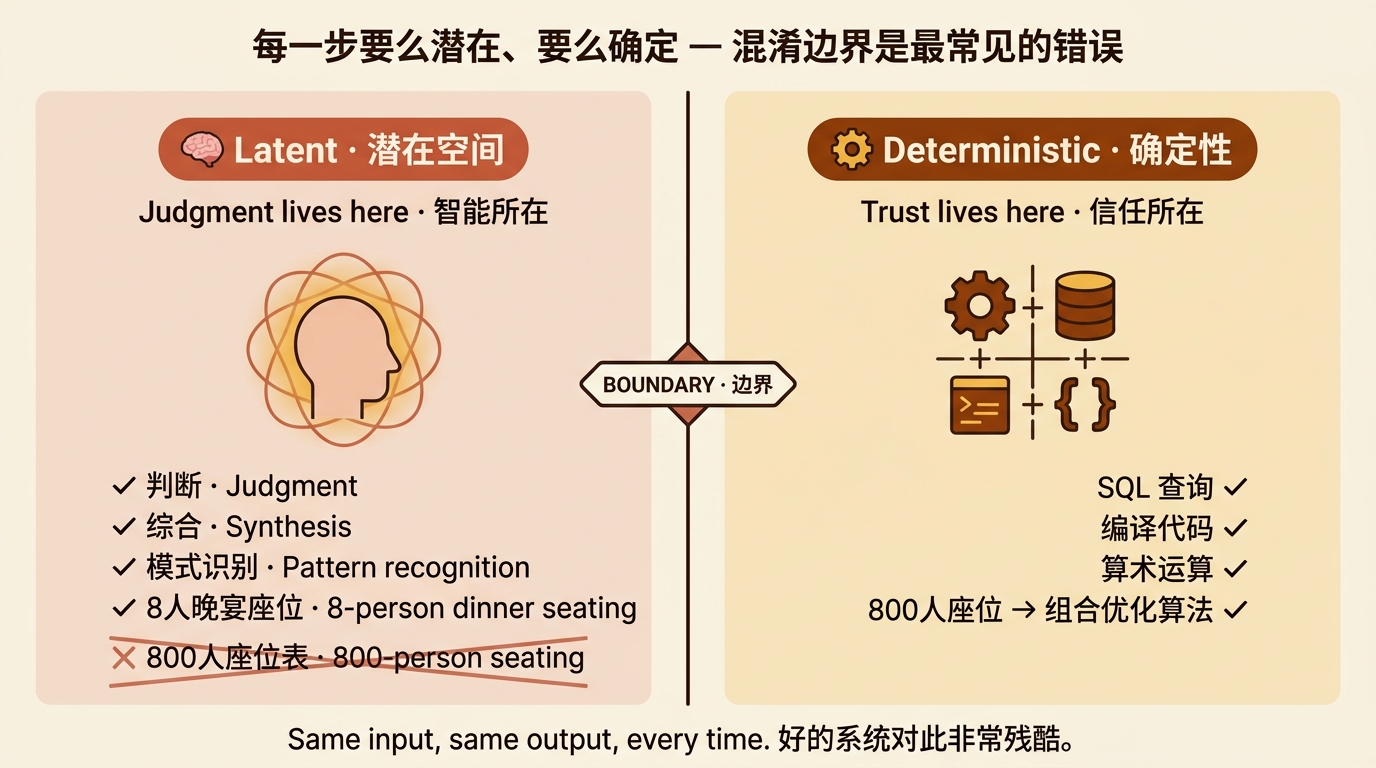
系统中的每一步要么是潜在空间,要么是确定的,混淆它们是智能体设计中最常见的错误。
-
Latent space(潜在空间):智能所在的地方。模型阅读、解读、决定。判断、综合、模式识别。
-
Deterministic(确定性):信任所在的地方。同输入,同输出,每次一样。SQL 查询、编译好的代码、算术运算。
LLM 能给 8 人排晚餐座位,考虑性格和社会动态。让它给 800 人排,它会编出看起来合理但完全错的座位表——这是组合优化问题,被强行塞进了潜在空间。
最差的系统把工作放错了边界。最好的系统对此非常残酷。
- Diarization
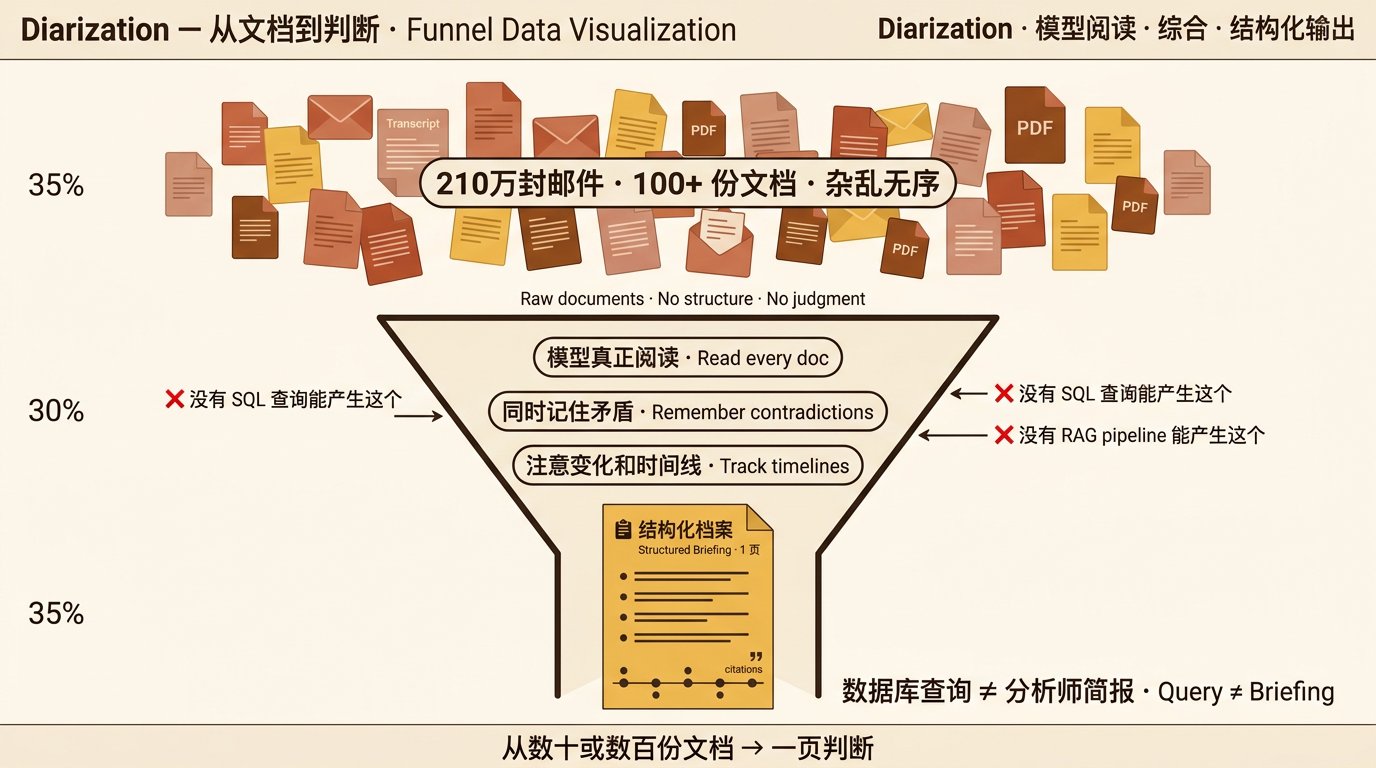
这是让 AI 对真实知识工作有用的步骤。模型阅读关于一个主题的所有内容,写出结构化档案——从数十或数百份文档中提炼出一页判断。
-
没有 SQL 查询能产生这个
-
没有 RAG pipeline 能产生这个
-
模型必须真正阅读、同时记住矛盾、注意变化和时间线,然后综合出结构化情报
这是数据库查询和分析师简报之间的区别。
架构
五个概念组合成简单的三层架构:
-
Fat Skills/厚技能:90% 的价值在这里(markdown 程序,编码判断、过程、领域知识)
-
Thin CLI Harness/薄马具:(约 200 行代码,JSON 进,文本出)
-
Your Application/你的应用:确定性基础,可信可靠(QueryDB, ReadDoc, Search, Timeline)
原则是单向的:
-
把智能推进技能
-
把执行推进确定性工具
-
保持马具薄
这样做,每次模型改进,自动改进每个技能,而确定性层完全保持可靠。
技能是永久升级
我给 OpenClaw 的一条指令,引发了比预期更强烈的共鸣:
你不允许做一次性工作。
如果我让你做某件以后还需要再做的事,你必须:
-
先手动做 3 到 10 项
-
给我看输出
-
如果我批准了,把它编纂成技能文件
-
如果应该自动运行,就加上 cron
测试:如果我不得不问你第二次,你就失败了。
这不是提示词技巧,这是之前描述的架构。
你写的每个技能都是对系统的永久升级。 永不退化。永不遗忘。凌晨 3 点你睡觉时它也在运行。而且下一个模型发布时,每个技能立刻变好——潜在步骤的判断变好,而确定性步骤完全可靠。
这就是 Yegge 100x 的方法。不是更聪明的模型。是厚技能、薄马具、和把所有东西编纂成规则的纪律。
系统会复合增长。构建一次,永远运行。
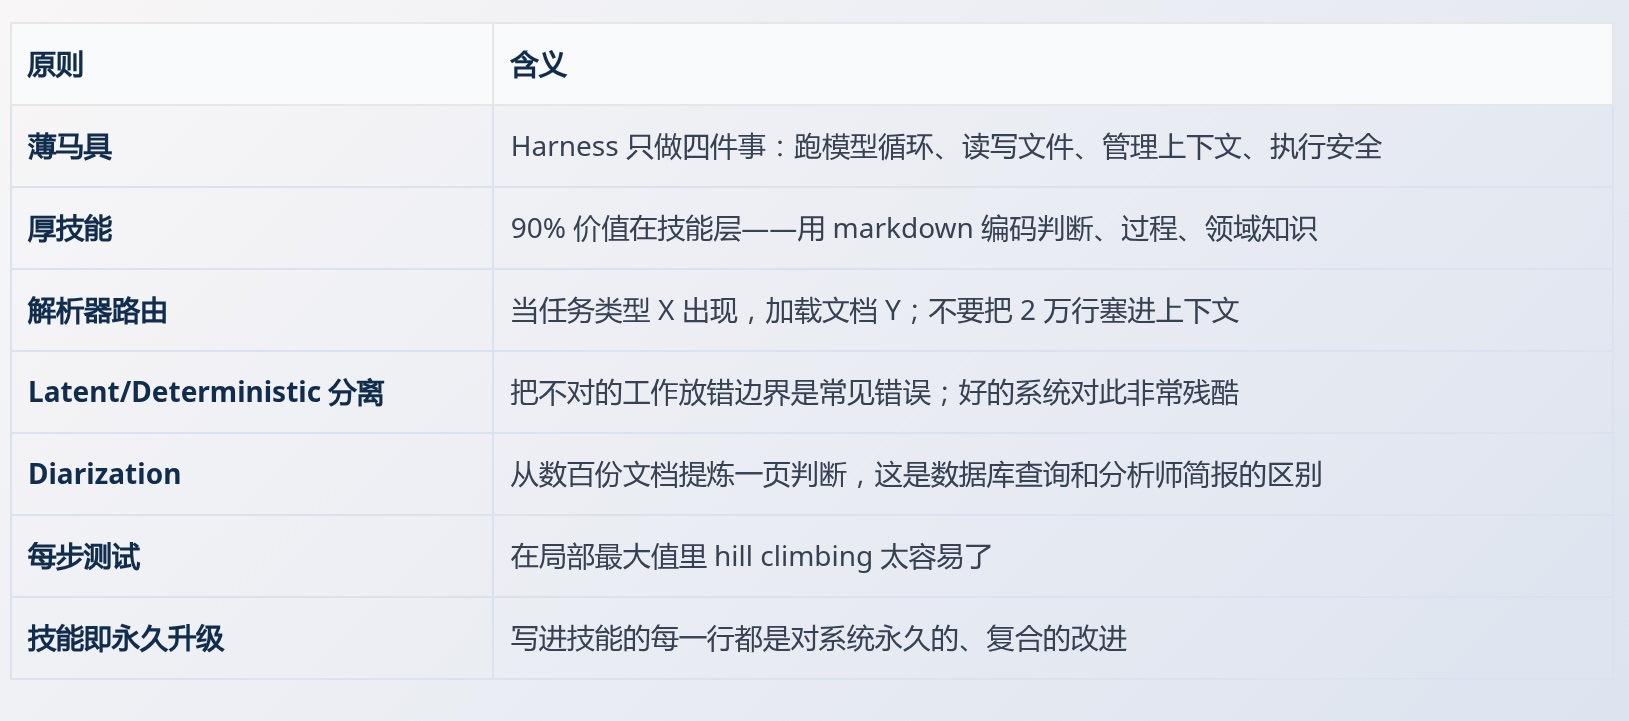
核心原则总结
原文链接:
https://x.com/garrytan/status/2042925773300908103